MIT机器人操作 知识点笔记(9):训练机器人需要什么样的数据——行为克隆(下)
- 2026-11-22 22:54:16
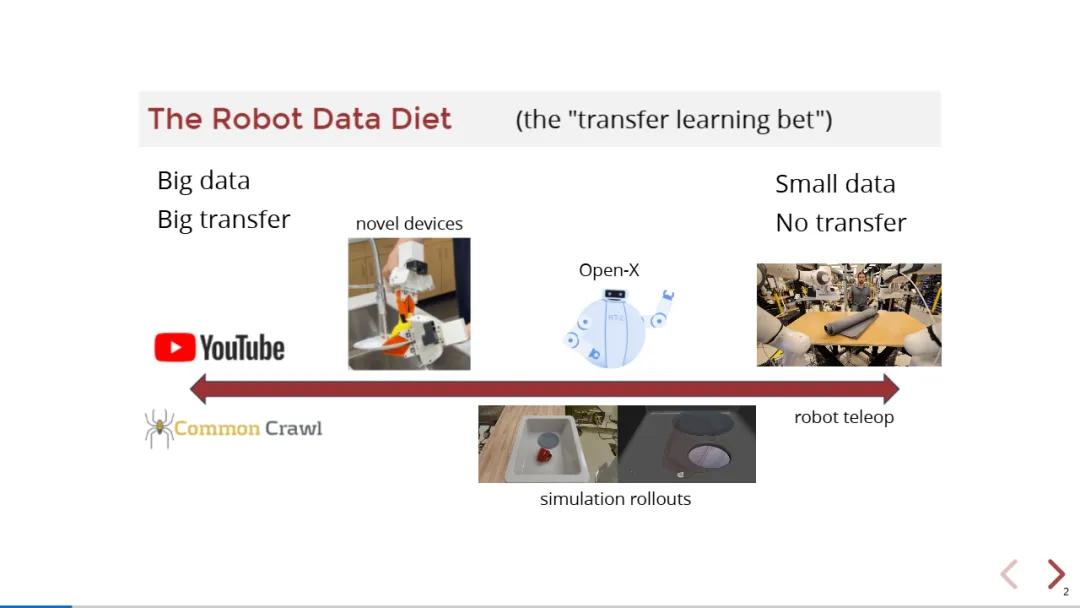
图 1 从右向左,可获取的数据量越来越大,也越来越远离特定的目标任务。
直接在目标任务上进行示范,通常最接近部署时的实际效果。这类数据能记录真实接触、传感噪声和执行延迟,但采集成本也较高。
利用来自其他机器人/仿真/互联网的数据可以增加覆盖。不过使用这些数据时,需要考虑清楚是利用它们补充哪一部分能力:
机器人训练所需的数据应该是不同来源的数据混合,包括:目标机器人数据、跨任务/跨机器人数据、第一视角人类数据、仿真数据以及互联网视频数据。要根据实际目标及数据可获得性,调整数据组合权重。
图一中的五类数据在动作标签、观察视角和采集成本上有明显差异:
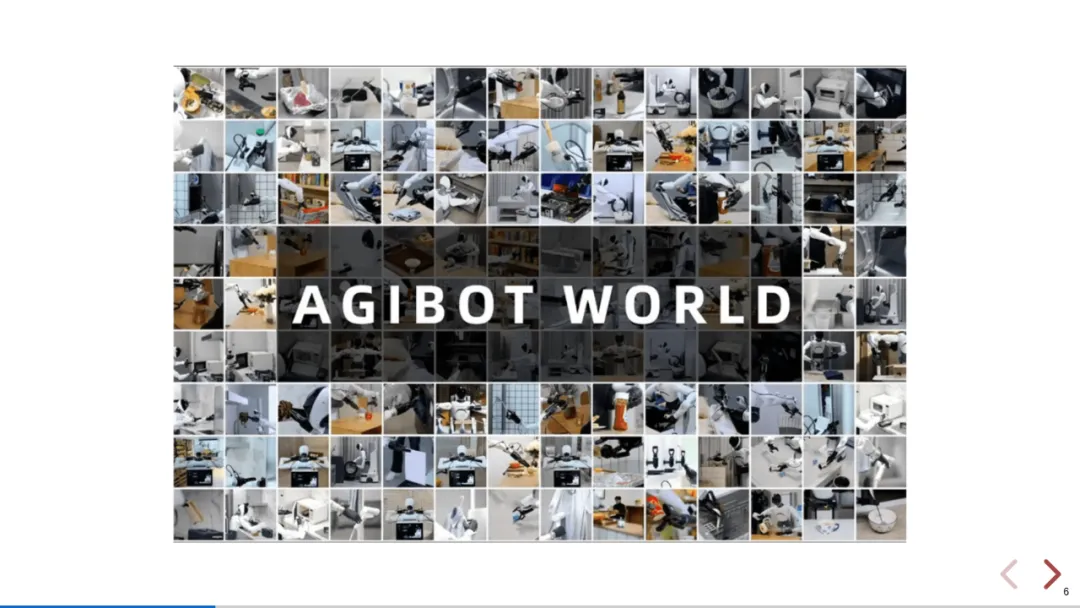
图 2 AgiBot World 展示了跨场景机器人数据的多样性;数据接入某个目标机器人时,需要核对动作定义及硬件差异。
AgiBot World 是大规模机器人数据实例。它适合用来观察任务和场景覆盖;对目标机器人的迁移收益,需要结合具体数据处理方式和任务评估判断。〔4〕
Open X-Embodiment 聚合了跨机构、跨本体的机器人轨迹,扩大了任务与硬件覆盖。使用这类集合时,动作格式、控制频率和数据质量的对齐成为训练准备的一部分。〔5〕
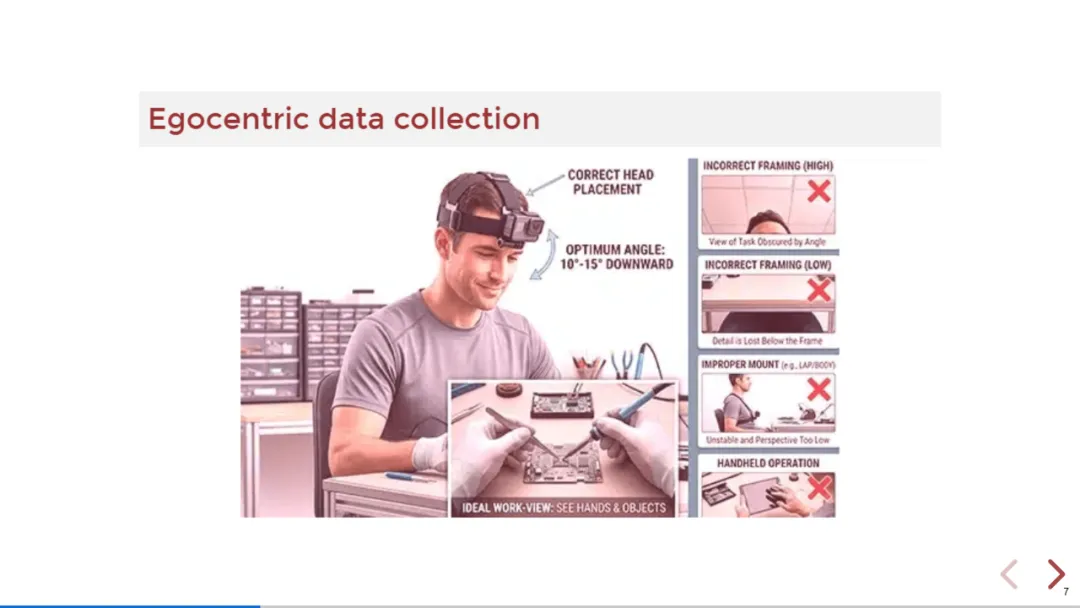
图 3 头部第一视角采集规范:相机稳定安装并略向下,使双手、目标物和工作区同时进入画面。
第一视角视频需要同时保留操作对象、双手和周围环境:
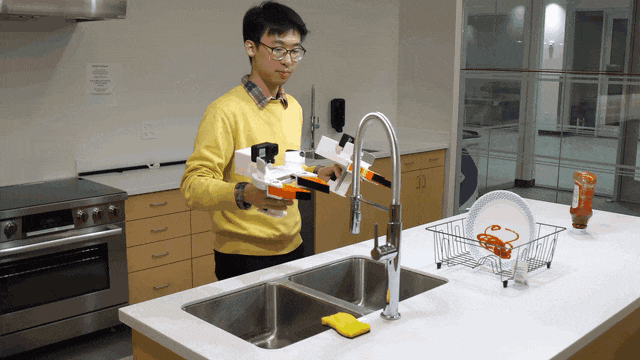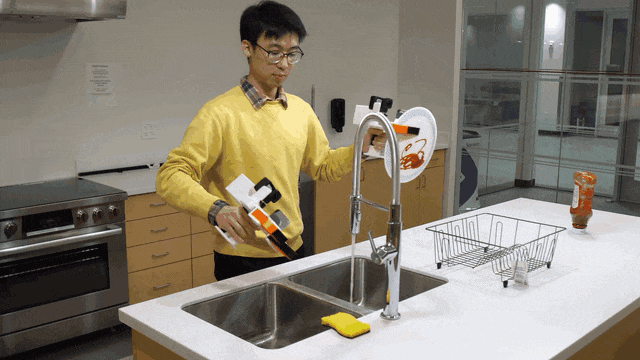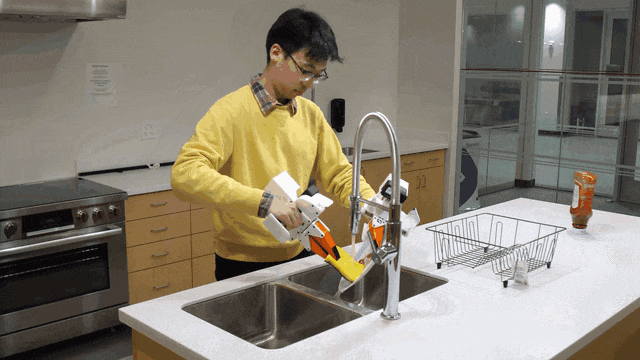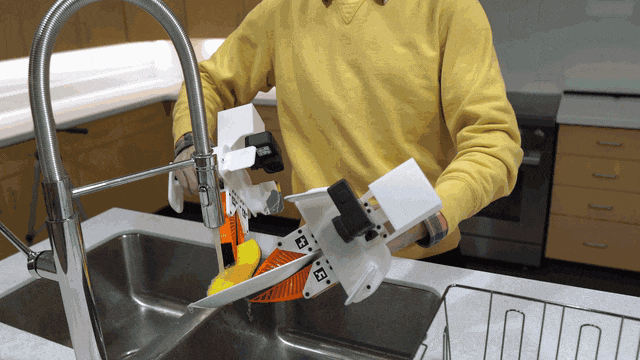
动图 1 操作者用便携式双手夹爪采集厨房洗盘示范,数据经重建后用于机器人学习。
UMI(通用操作接口)[2]提供了一种便携示范采集思路。处理这类轨迹时,图像、末端位姿、夹爪开度和事件标签需要对齐到统一时间基准。如果图像对应动作执行后的状态,训练得到的“观测—动作”关系就会错位。〔6〕
机器人动作会包含位置、旋转、夹爪开合等完全不同的物理量,其数值尺度往往差异较大。因此训练前需要从训练数据中计算各维度的统计量,对动作和状态进行归一化。常见的形式是:
上式中, 是第 个动作维度, 和 是相应统计量, 用来避免分母为零。不同模型可以采用不同的归一化方案。
同时模型部署时必须使用相同统计量进行处理和反归一化,否则动作的实际幅度可能发生偏差。对于多机器人联合训练,如果不同机器人之间动作幅度/动作分布差异很大,就还需要考虑对不同类型的机器人进行分别归一化。〔7〕
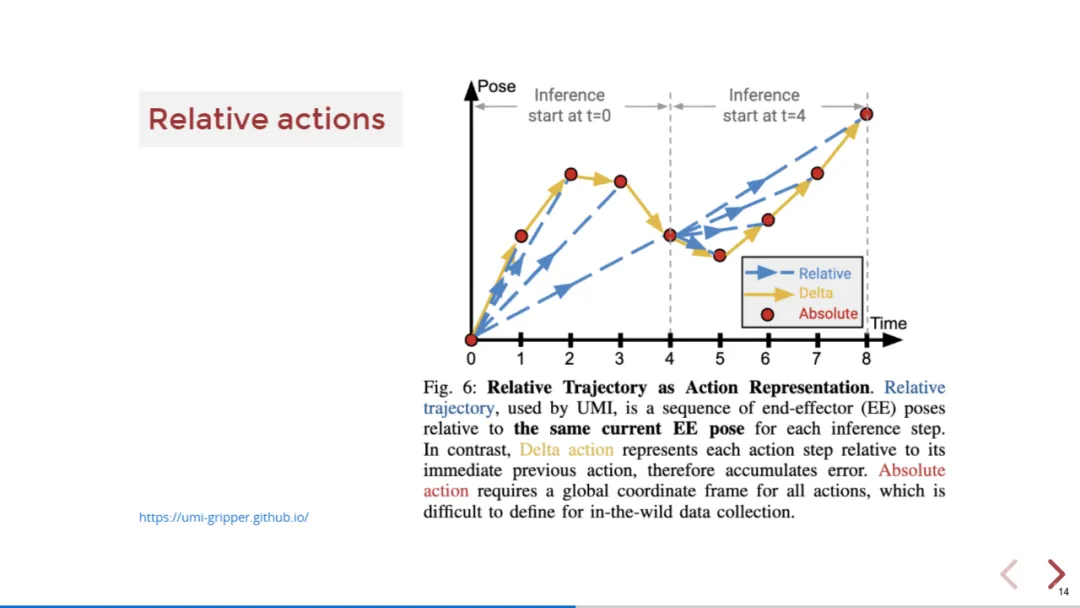
图 4 相对轨迹、逐步增量和绝对动作三种方式的比较。相对轨迹可以避免误差的不断累积。
机器人的末端位姿态可以用齐次变换 来表示。而相对轨迹可写为:
一个动作块中,未来多个位姿都相对于本次推理开始时的 表达。而逐步增量则使用 ,需要依次组合这些增量,这就可能会导致误差在整个过程中累积。相比较而言,相对轨迹减少了这种链式累积,也降低了对统一世界坐标的依赖,更便于迁移到不同场景和机器人上。〔6〕
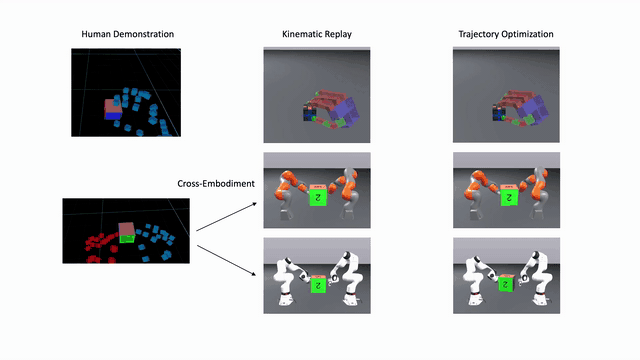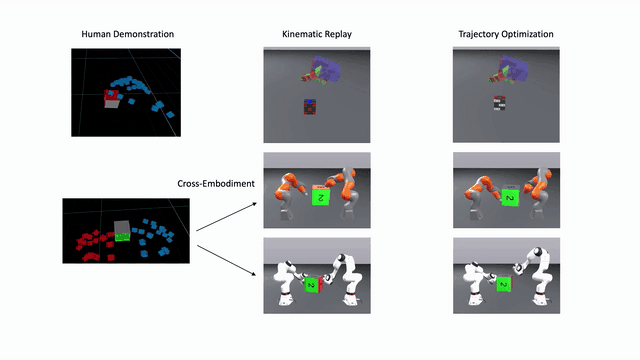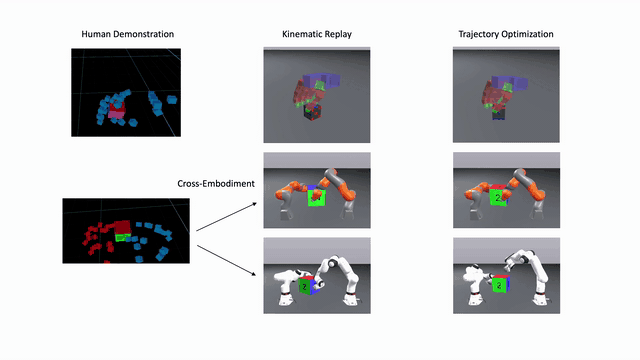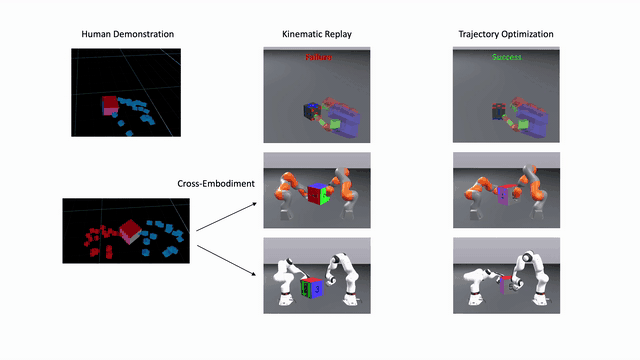 动图 2 PhysicsGen将少量人类示范经过运动学回放、轨迹优化,生成适用于不同机械臂的轨迹。
PhysicsGen是一套基于物理仿真的机器人训练数据生成框架,可基于少量人类示范扩充成大规模训练数据。它的处理流程是: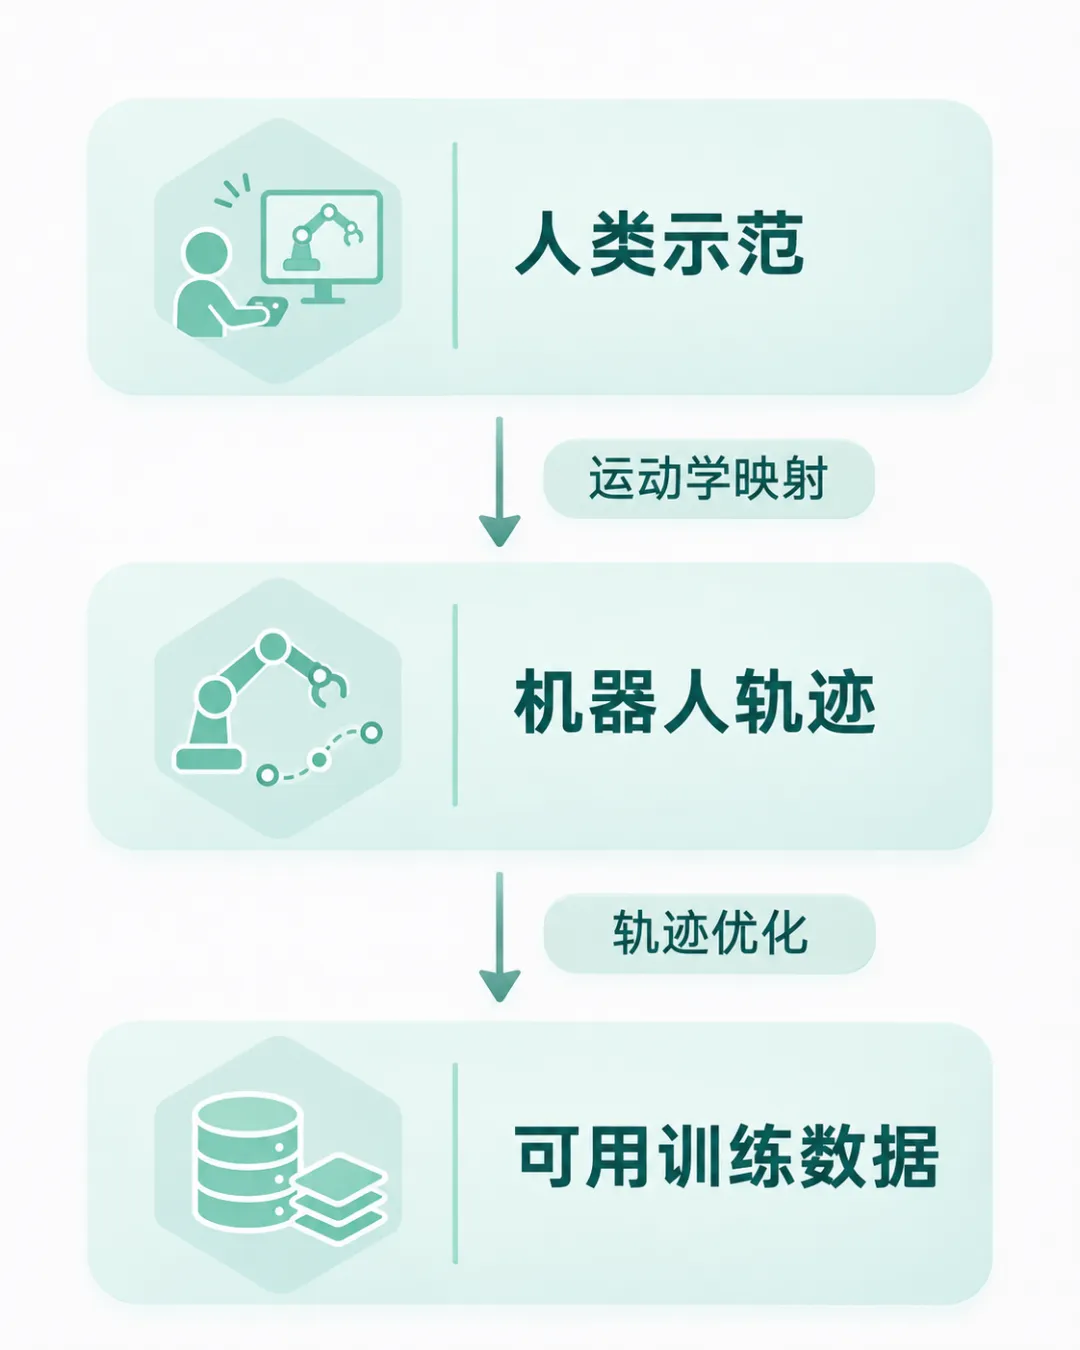
PhysicsGen 利用少量VR人类示范,通过运动学映射将动作迁移到不同机器人本体,再结合仿真动力学和轨迹优化,生成大量满足物理约束的操作轨迹。这些数据可用于训练 Diffusion Policy 等模仿学习策略,从而减少数据采集成本,并提升跨机器人数据复用能力。〔9〕
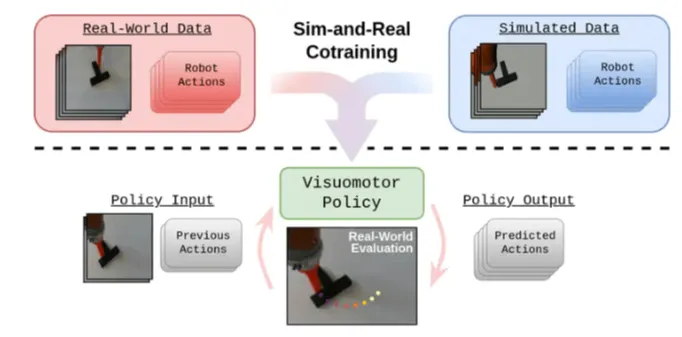 图 5 同一视觉运动策略使用真实和仿真示范联合训练,最终在真实环境评估。
Sim-and-Real Cotraining(仿真数据与真实数据联合训练)的核心思想是把真实机器人采集的操作数据和仿真环境生成的操作数据放在一起训练同一个运动策略,利用仿真数据扩大训练规模,同时又利用真实数据帮助模型适应真实环境。可以将联合训练目标写为:
是训练损失, 调节仿真数据项的权重。权重和数据量需要结合目标任务评估。
真实机器人实验结果如下:
针对这项实验的结果发现:
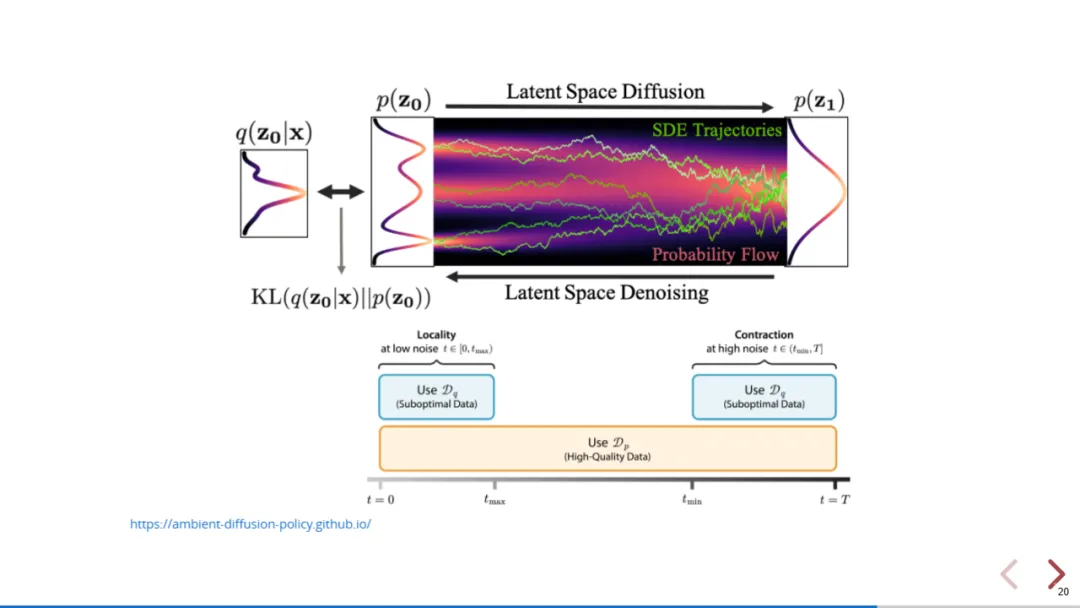
图 6 高质量数据可以用于整个扩散训练过程,而低质量数据只在特定噪声水平参与训练。
Ambient Diffusion Policy 利用扩散模型在不同噪声水平下学习不同动作特征的性质,选择性地使用次优示范数据:
(图中橙色)是高质量目标数据, (图中蓝色)是次优或与目标任务存在分布差异的数据。上式把噪声等级分成三个区间:
项目报告在噪声示范、仿真与真实域差、任务错配以及Open X-Embodiment混合数据的实验中,相比普通联合训练取得了更好的表现;效果受任务、阈值和扩散策略架构影响。〔11〕
核心原则: 先保证数据定义一致、时间对齐,再考虑增加数据量。
最终评估要回到目标机器人的实际任务:哪些初始条件能够完成,哪些恢复过程仍会失败,新增数据具体改善了什么。实验中得到的这些信息,可以继续用于补充数据或进行策略优化。
MIT 6.4210/2 机器人操作 知识点笔记(1) MIT机器人操作 知识点笔记(2):机器人学习概览 MIT机器人操作 知识点笔记(3):坐标系与坐标变换 MIT机器人操作 知识点笔记(4):基础运动学 MIT机器人操作 知识点笔记(5):运动学优化 MIT机器人操作 知识点笔记(6):运动规划 MIT机器人操作 知识点笔记(7):机器人触觉仿真及抓取姿势生成 MIT机器人操作 知识点笔记(8):让机器人从示范中学会操作——行为克隆(上)

