罗格斯教授当众破防:每学期重写整套教材!AI伪造学会假象,高校爆发零分惨案
- 2026-11-23 00:25:19
镜头前,布莱恩·比绍夫(Bryan Bischof)摊开手,道出一句戳痛无数大学老师的实话:
“我完全不知道该教什么了
每个学期,我都得重写整套教材”
比绍夫绝非落伍的学院派
他是纯数学博士,曾带队开发数据分析平台 Hex 的 AI 助手;
如今既是硅谷风投 Theory Ventures 的 AI 负责人,也在美国罗格斯大学给研究生讲授数据科学与 AI 工程。
在晨间访谈节目《AI in the AM》里,完整视频甚至顶着《我不会让孩子去学数据科学》的扎眼标题。
但他并非唱衰行业
相反,他曾公开直言,现在正是数据科学有史以来最好的黄金期。
他的教学目标很清晰:在智能体自动跑分析的时代,帮学生练出用数据解决真实商业难题的硬本事。
可一走上讲台,两堵高墙便迎面砸来
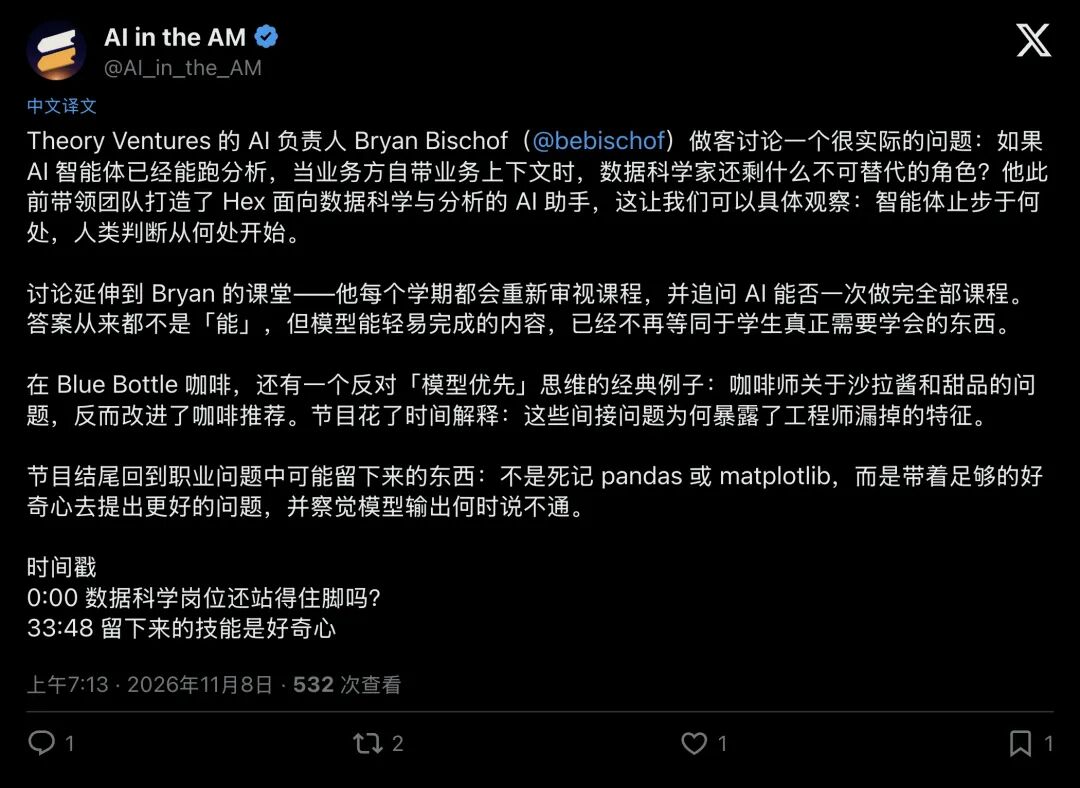
▲ 访谈节目《AI in the AM》梳理比绍夫重审课程与数据科学核心价值的要点
01满分作业与零分考场:被伪造的“学会铁证”
每个学期,比绍夫都会测试 AI 能否把整门课“一枪打穿”。
至今还没有哪个模型能一次性通关
可棘手的盲区,恰恰藏在模型能做好的那一半任务里。
作业交上来工整漂亮,老师再也分不清:学生是真学会了,还是只把题目喂给了 AI?
几百年来,现代教育依赖一条潜规则:好作业等于好脑子。
跑得通的代码、规范的报告,曾是苦思冥想的收据。
如今 AI 零成本印出了完美假收据
平时一片繁荣,师生都误以为学习发生了。
直到撤掉屏幕,真相惨不忍睹
人机交互顶会 CHI 2026 的一项计算机课研究记录了惊人一幕。
一位教授在 450 人的大课里引入“绝不直接给代码”的定制助教机器人,学生平时作业表现极佳;
可到了期中现场手写简短 Python 函数时,整整三分之一(150 人)直接考了 0 分。
更有平时高分过关的学生坚称自己全懂,被当面追问代码细节时却哑口无言。
连博士生也会被模型的“表面流畅”催眠。
新西兰奥克兰大学追踪 32 名博士生的统计课发现:学生玛丽向 ChatGPT-4o 请教相关系数用法,拿到了极其专业的对比与软件点击指南。
过度信赖这份工整指南的她,压根没核查自己的数据底子,相当于拿量身高的尺子,硬去算“非常满意、一般满意”的平均值,交出一份格式满分、结论全废的报告。
反观同伴互评组,同学只让搭档当场重跑一遍,就一眼揪出:“你第一步就开错数据文件了。”
02两周就过时的讲义:困在“狂野西部”里的老师
看穿假象,改教材不就行了?
没那么容易
第二道障碍,是技术狂奔对教学周期的碾压。
比绍夫苦笑说,教应用 AI 工程就像打肾上腺素。
课程刚诞生两年,每个月都在变;
往往距离开讲“工具调用”只剩两周,行业就出了新协议,刚写好的讲义还没发下去就过时了。
学界将这种高频返工称为“应急性教学设计”。
针对 169 位计算机系教师的调查显示,81% 的老师愿意拥抱 AI,却认为只有 28% 的同事想法一致。
大学沦为规则混乱的“狂野西部”:这门课鼓励用,隔壁课当剽窃抓;
甚至有学生在纸笔考场上把手机夹在腿间拍题发群,靠场外同伴跑 ChatGPT 传回答案。
缺范式、缺经费,想改革的老师只能孤军奋战。
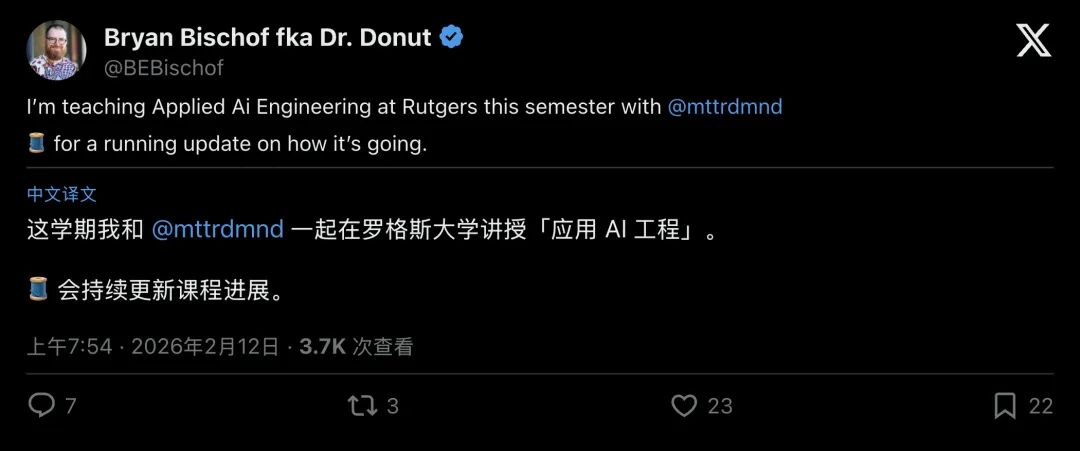
▲ 比绍夫连载罗格斯大学《应用 AI 工程》课程重构进展
03拆掉课后作业:3小时速通基础,50名助教贴身肉搏
困局之下,一场激进的自救行动在高校铺开。
比绍夫率先对“教什么”动刀
在罗格斯春季新课上,他用第一讲 3 小时极限速通传统数据科学基础,再用第二讲 3 小时建立大模型直觉。
死记 pandas 或 matplotlib(两个常用的数据整理与画图工具包)的时代彻底翻篇。
核心课时全部推向一线实战:搭评测系统抓模型漏洞、做上下文工程、划定智能体边界。
“怎么考”的变动同样剧烈,大批老师干脆拆掉了课后作业。
卡内基梅隆大学的凯斯特纳教授在 AI 做完所有课后题后,把百人大课全面转向口试、助教质询与视频演示。
更有计算机教授把代码提交分砍到 15%,将 85% 的成绩绑在每周真人“代码站会”上,当面拷问数据流向。
代价同样高昂:为撑起 300 人的面谈,他招募了超过 50 名助教,用 1:6 的人海战术死守底线。
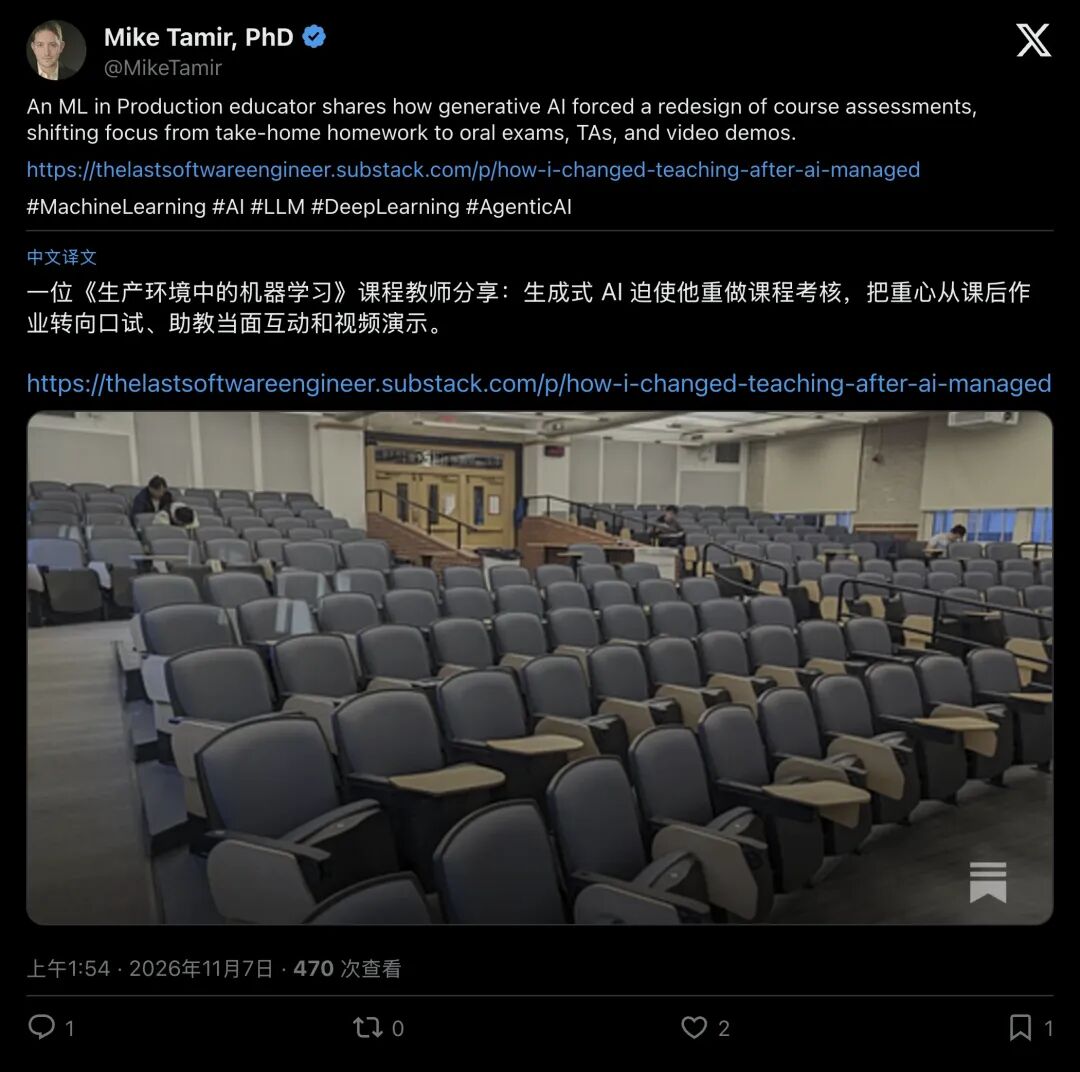
▲ 机器学习教师分享放弃课后作业、转向口试与视频演示
04沙拉酱打败算法:幸存的“好奇心”怎么打分?
当写代码与画图表都被接管,人类分析者究竟还剩什么不可替代?
比绍夫给出了两个绝妙切片
一是“惹怒用户的问卷题”
某道调查题预测极准,却冒犯感极强,问完用户就流失了。
模型事后能算出流失规律;
唯有顶尖人才会在上线前就嗅出风险,把“别伤及业务”算进问题本身。
二是他在精品咖啡品牌蓝瓶咖啡(Blue Bottle)组建数据团队的往事。
工程师忙着调优推荐算法,咖啡师却爱问顾客看似跑题的闲话:“你拌沙拉爱用什么酱?
喜欢什么甜点?”
结果,正是这些旁敲侧击的追问,挖出了工程师漏掉的口味特征,大幅提升了咖啡推荐质量。
拼模型拟合,机器更强;
跳出表格去问“沙拉酱”,全靠人的判断
比绍夫由此总结:“我共事过的最顶尖的数据科学家,好奇心都强到近乎烦人。”
然而,评论区里学者埃里克·布朗的一句反问,再次刺中痛点:“我真好奇他怎么给这种好奇心打分。
那大概是评分表上最难写进去的一项了。”
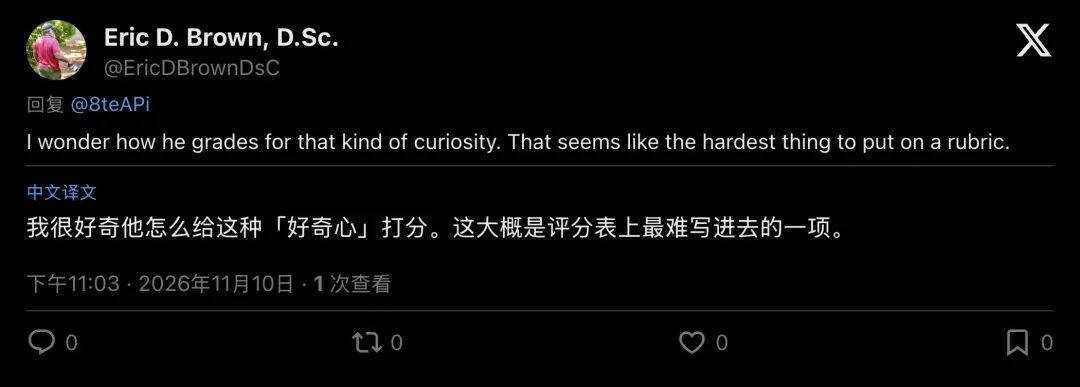
▲ 网友一针见血:好奇心怎么写进评分标准?
这正是整个时代最痛的转身
旧评分表奖励“交出标准答案的乖学生”,可标准答案如今近乎免费。
所谓“烦人的好奇心”,底色是一种拒绝被流畅假象催眠的“认知怀疑”。
AI 并未终结数据科学,它剥去了这门手艺的机械外壳,逼着所有人直面新铁律:当机器一秒能答出万物,人类最后的护城河,在于察觉哪里不对劲、并死磕到底的洞察力。