70家机器人驾校,抢1000万小时教材
- 2026-11-21 20:31:09
早上九点,北京亦庄一间近六千平方米的实训基地里,小刘穿戴好采集装备,站到化学实验台前。夹托盘、称粉末、放回原位。她不是实验员,她做的每一个动作,都是演给旁边的机器人看的。
这样的演示,她一天要做几百遍,而且不能做重样。托盘的位置随机挪,粉末的克重随机换,物品的颜色形状数量打乱组合。她旁边,上百台不同构型的机器人在各自的操作台前"有样学样",屏幕上轨迹数据实时滚动回传。
为什么企业愿意养一批人,专职给机器人当示范?答案有点意外:现在的机器人会走路、会翻跟头、能跑百米,可进了车间不敢直接用。缺的不是腿,是教材。
人民网科普频道十月十三日的报道里有一组悬殊的数:全球可用的高质量真实数据,只有几十万到百万小时级;而机器人要迎来自己的"ChatGPT时刻",需要的是千万小时级。好比一个人学做菜,只看过十几小时的菜谱视频,就得直接上灶开饭店。
原以为卡住这个行业的是芯片和电机,结果是上课时间不够。造的那一头其实跑得很快:今年上半年我国人形机器人出货超过4万台,全球占比升到97%。制造端"造出来"已不是问题,"用起来"中间隔着一道数据关。
难在哪,信通院的报告写得直白。机器人练单一任务,能力很快就到头;真正难的是泛化,也就是换了环境、换了活儿还能不能干。好比只会在自家厨房做饭的人,灶一换就抓瞎。泛化没法凭空教,只能靠大规模真实场景的数据一点点喂出来,而数据只能从机器人的规模化部署里来。
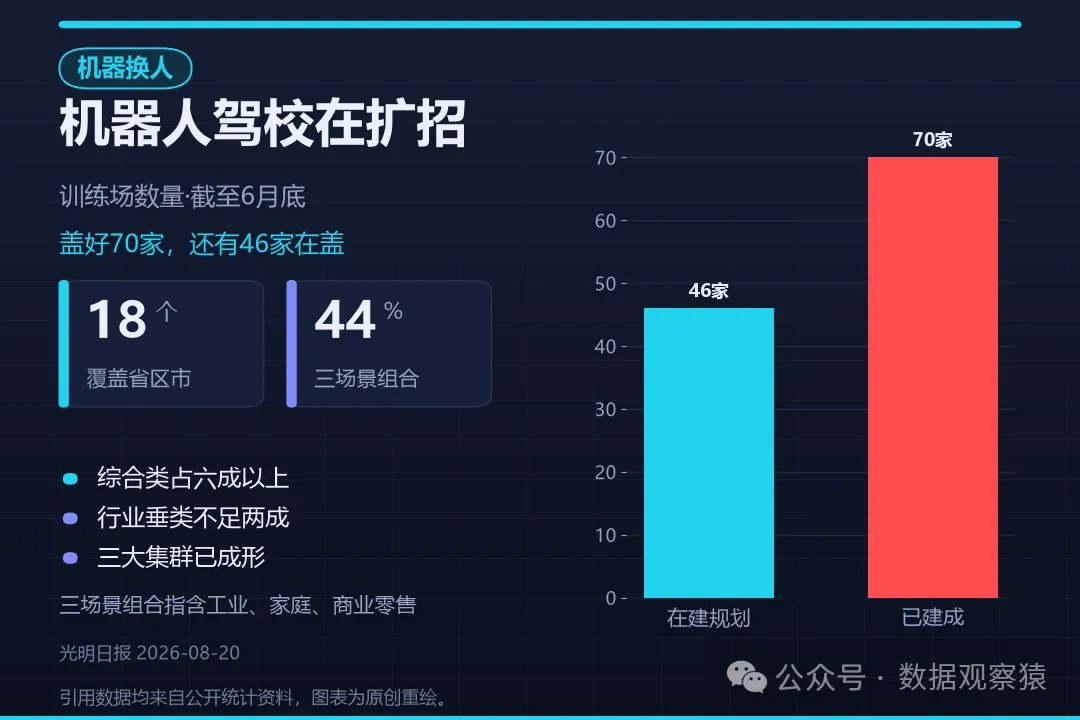
数据关催生了一个新行当。中国信通院八月十八日发布《具身智能训练场研究报告(2026年)》,截至六月底,全国建成启用的具身智能训练场超过70家,在建或规划的还有46家。你可以把它理解成机器人的驾校:先在封闭场地练会,再上真实路况。
这些驾校的分布也值得看一眼。覆盖了过半省级行政区、18个省区市,长三角、京津冀、珠三角三大集群之外,一路下沉到三四五线城市。六成以上是面向多行业的综合类,专攻单一行业的垂类不足两成;工业、家庭、商业零售三件套配齐的,占综合类的44%。
供给侧的天花板也露头了。中关村一家训练场已经交付了150万小时的人类视频数据,自称世界顶级水平;可高质量具身大模型的训练,通常要1000万小时甚至1亿小时起。最好的那一家,离需求还差着一个量级。
更麻烦的是水分。基地产品负责人史明威对记者说了实话:市面上不少训练场宣称自己有"多少万小时、亿小时"数据,"实际可用的是从中抽离出的高质量数据"。小时数好攒,合格课时难凑。
小刘们干的就是筛水的活。一条演示几秒钟,手抖了、放歪了,重录。项目经理刘磊说,数据采集员的每次操作,都是在物品形状、颜色、数量、位置随机变化的场景里反复采样,机器人才不光会模仿,还能慢慢学会应付没见过的局面。
这个行业把这当成破关的钥匙:机器人进的真实场景越多,采回来的数据越多,模型就越强,下一批产品就越好用。企业管它叫"产品应用、数据积累、模型迭代、产品升级"的循环。循环的第一环,就踩在训练场的地面上。
工信部预计今年全年人形机器人产量有望突破10万台。产量每往上跳一格,教材缺口就跟着涨一截。十万个新学生等着开课,驾校和老师都还在赶工。
等这千万小时一点点凑齐,第一批"毕业"的机器人,可能已经站在某个车间里了。它们的成绩单上,写的会是小刘们重复过的那几百遍动作。
引用数据均来自公开统计资料,图表为原创重绘。

