有人开源了小学初中高中各科教材的知识图谱skill?
- 2026-11-19 09:00:45
孩子一道题卡住了,到底是再练两道,还是先把前面的知识补一补?cn-math-taxonomy 构建了一套知识图谱,能帮你顺着知识点往前找。你选一个知识点开始答题,它会根据回答继续出题,检查哪些地方还不稳,再给出建议复习顺序。想看看一章或一本书学得怎么样,也能直接选范围来测。
目前收录了 8 个学科,整体从小学延伸到高中,不过各科收录的年级不一样,后面有明细。项目按 CC BY-NC 4.0 提供代码和数据,非商业使用要遵守署名等协议条件,商用需要另行授权。
01
它现在能帮你做什么
先看你能拿它做哪些事。
· 一道题不会,往前找找卡在哪儿。 选中知识点开始答题,需要时,它会接着检查前面的知识,看看已经测出的薄弱点有哪些。
· 一章学完,看看哪里还没学稳。 可以按章节或整册来测。掌握了多少、哪里不稳、哪里薄弱,结果会分开列,没测到的仍然显示“未测”。
· 知道哪里薄弱,再决定先补什么。 结果页会给一条建议复习路径。后面的内容要用到前面的知识,就把前面的排在前面。
· 准备给孩子讲题,先看看知识怎么连。 搜到一个知识点,就能看它的通俗解释、掌握标准和相关题目,也能看为什么要先学另一块知识。
· 这次没做完,下次接着来。 档案和答题进度可以保存在本地。结果能导出、打印,也能做成一张手机分享图,之后还可以重测。
拿配方法的演示来说。程序顺着前面的知识往回查,最后查到了“完全平方公式”。这样你能看到配方法和它有什么关系,也知道下一步可以先复习什么。这里是程序模拟作答,展示的是操作流程,不是真实学生的测评结果。
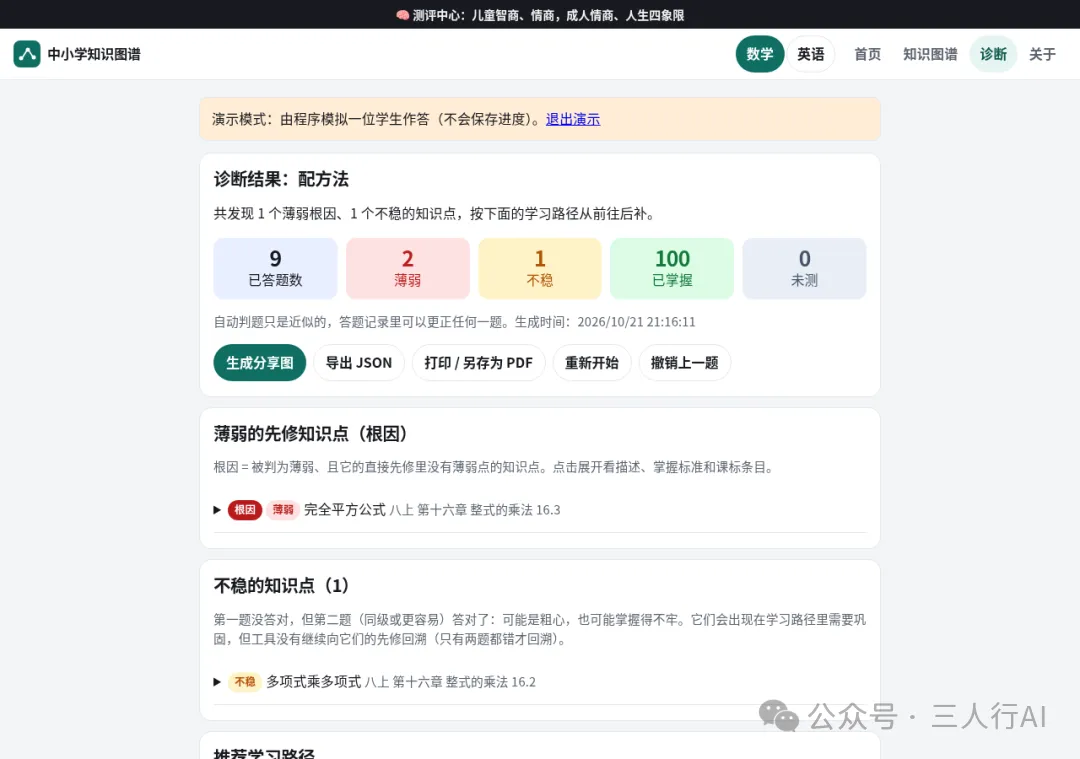
配方法诊断结果,演示回溯到完全平方公式
名字里虽然有 math,它现在已经不只做数学。接下来先看怎么用,后面再说它是怎么实现的。
02
从一道错题开始,找复习线索
先在图谱里搜孩子正在学的知识点。比如搜“配方法”,页面就会把它和前面要用到的知识连起来。点开一个节点,还能看说明、掌握标准和诊断题,也可以从这里开始答题。
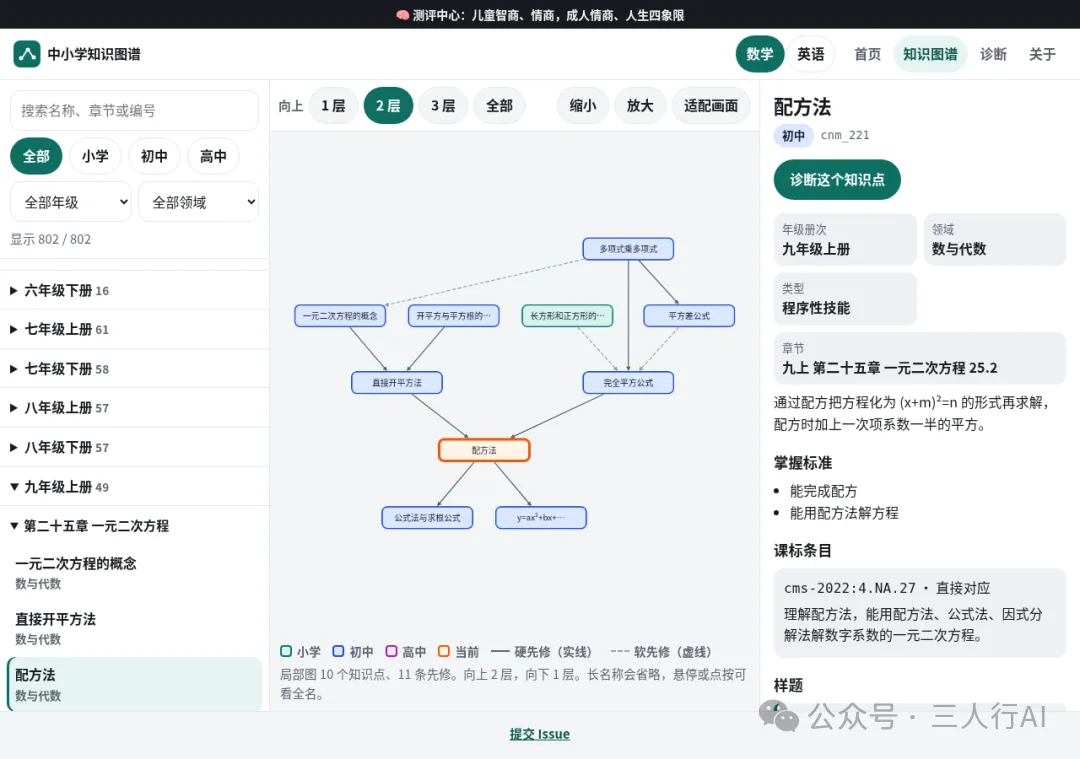
配方法附近的局部知识图谱
图谱一开始只显示附近的关系,往上两层、往下一层,不会一下把整张图都铺出来。想看得更远,可以继续展开前置知识。你也能搜索、筛选,或是缩放、拖动图谱。备课和讲题之前,先顺着连线看一遍,就能大致了解前后要用到哪些知识。
答错一道题,它通常不会马上往前查,而是再给同一个知识点出一道确认题。确认题也没答对,才继续检查前面的知识。如果第一题错了、确认题对了,它会记成“不稳”,默认不再往前查。一次失误,还不足以说明前面的知识没学会。
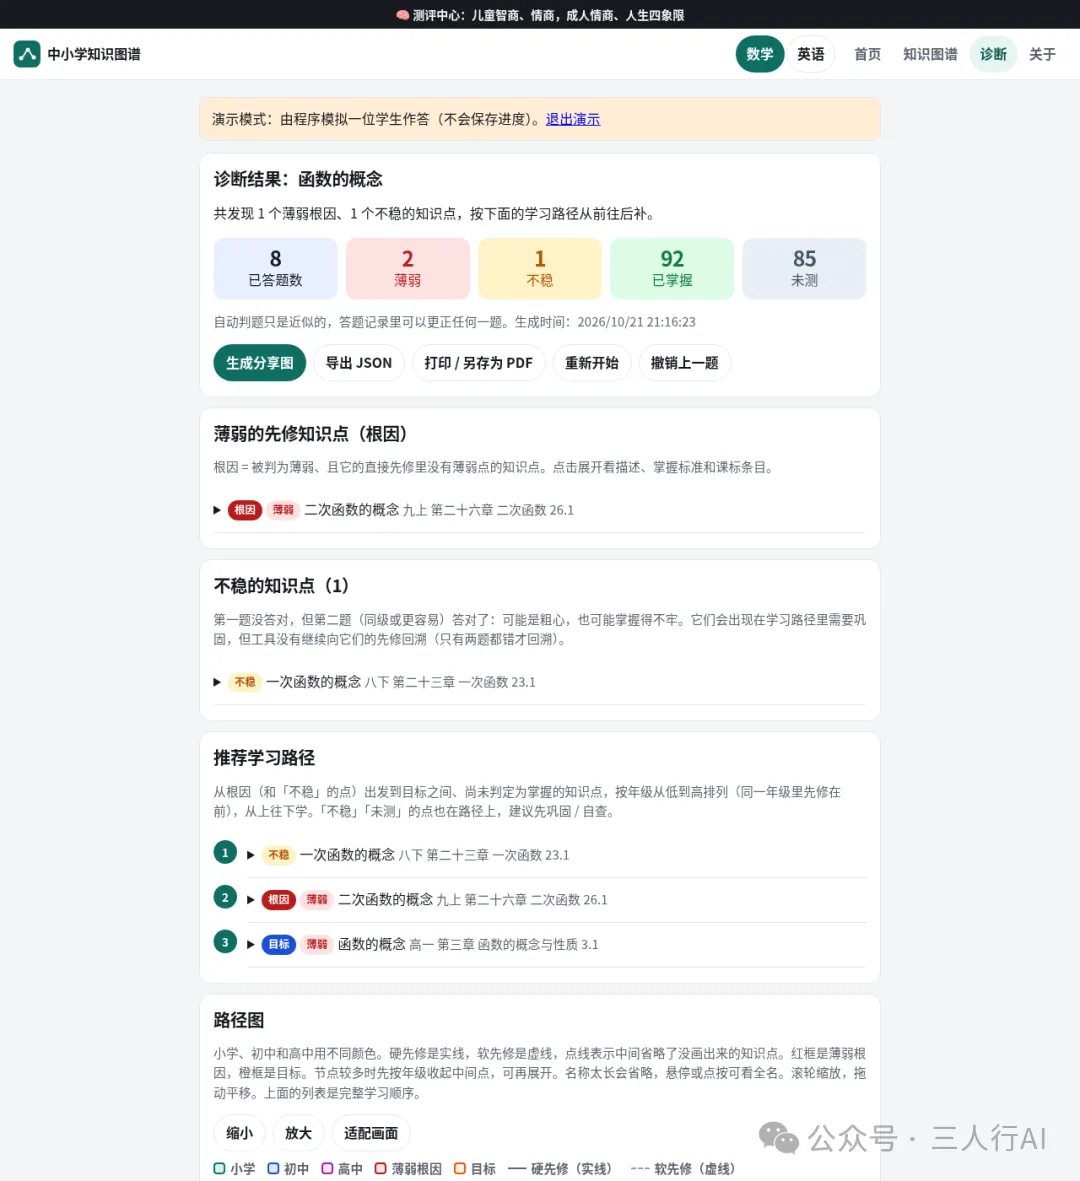
高中函数概念的诊断演示
从一个知识点开始测,可以一路查到更早学段的知识。结果里写的“根因”也要这样理解:在这次已经测过的范围里,暂时没找到比它更早的薄弱点。没测到的地方,仍可能有问题。你可以把它当成下一步复习的线索。
03
学完一章或一本书,也能做筛查
如果只是觉得“这一章好像还有些地方不会”,但说不出具体是哪一块,就可以选章节或整册来测。测完以后,页面会列出各类状态的数量,标出薄弱点,再给出建议复习顺序。
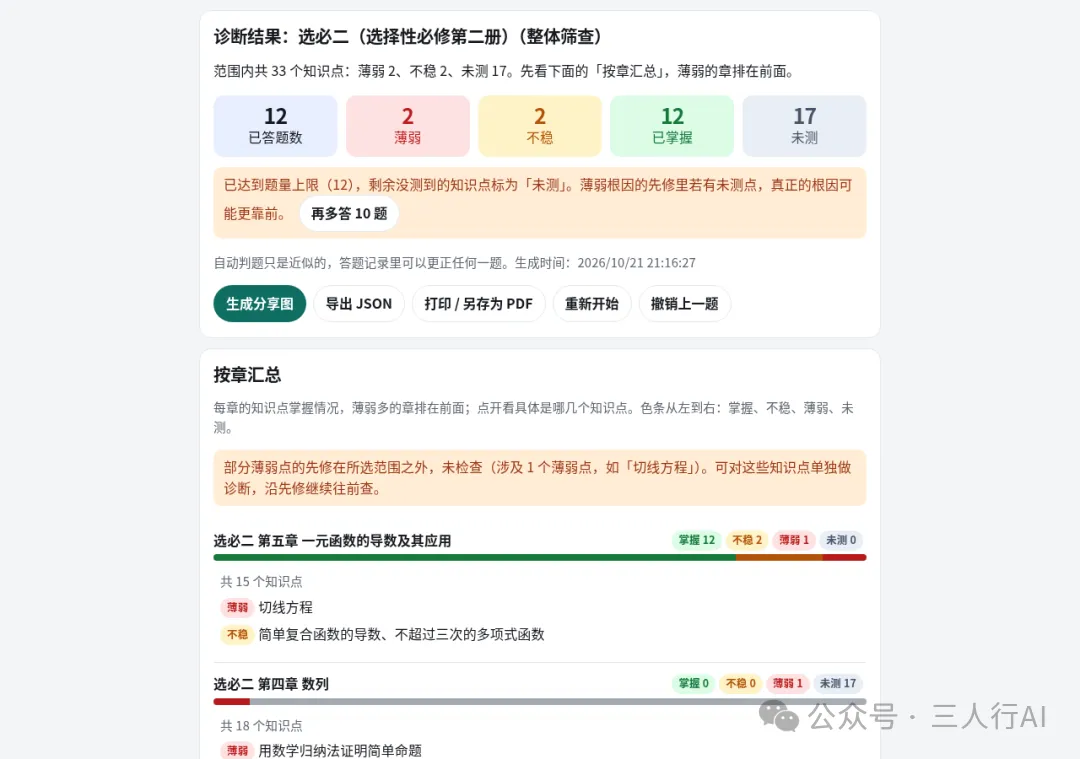
选择性必修第二册整册筛查示例
整册测和单点测,范围不一样。选了一册,主要就查这一册里的知识,册外要用到的知识会单独列成“未检查的前置知识”。到了题量上限就会停,没测到的点还是“未测”,不能顺手算成已经掌握。
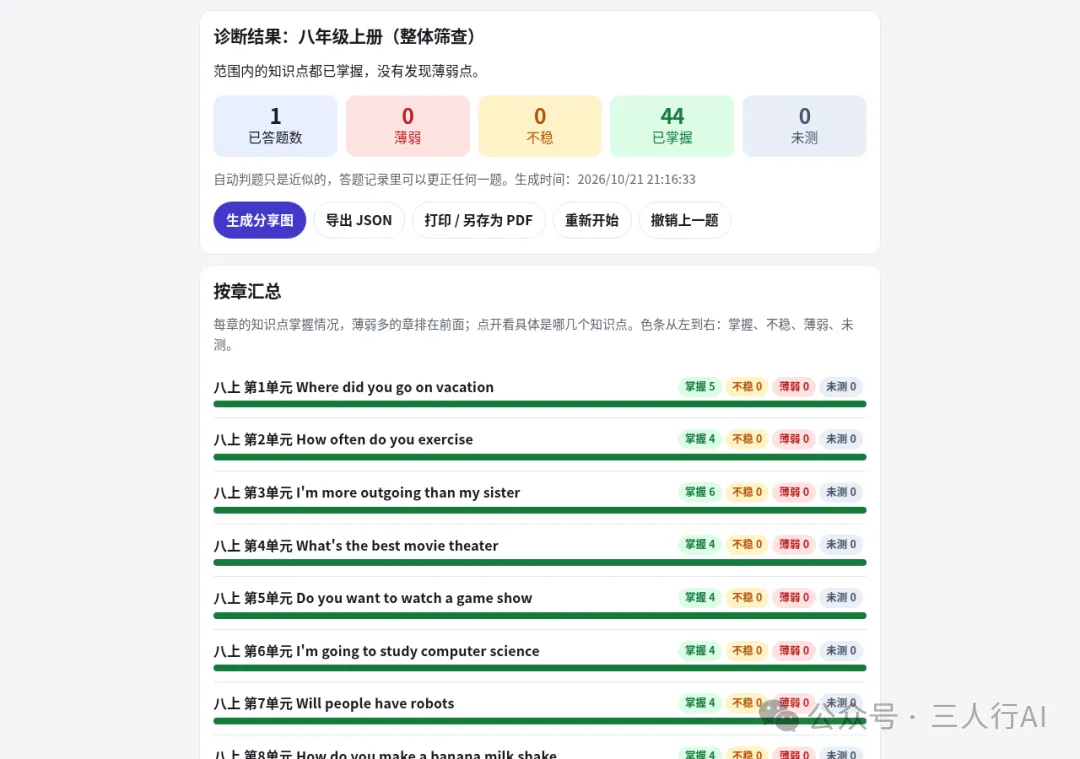
八年级上册英语整册诊断示例
复习路径先按年级排,同年级里,后面要用到的基础知识排在前面。你可以照着挑一块先复习,过后再测这个薄弱点或对应章节,看看这次能不能答对。
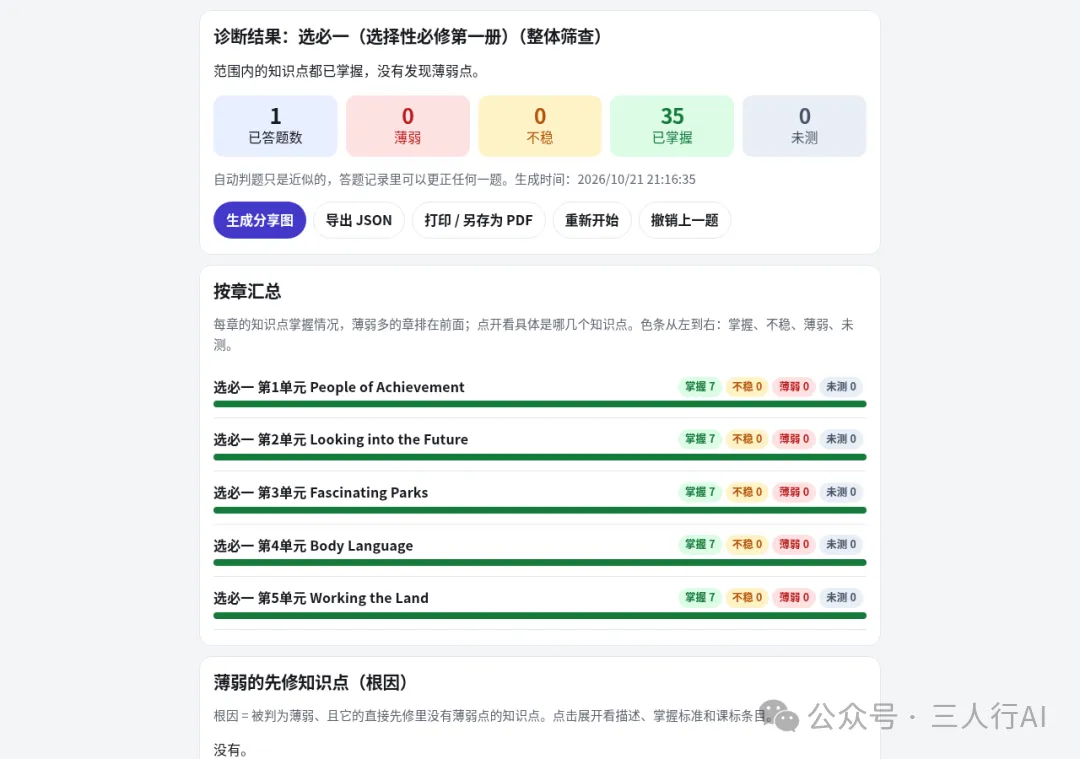
选择性必修第一册英语整册诊断
04
结果可以保存,也能打印和分享
选择题主要看选项对不对。数值题能识别分数、小数、百分数等简单的等价写法。碰到没法可靠识别的代数式或文字答案,页面会把参考答案给你看,让你自己判断。答完能看解析,判错了也能手动改,或者撤销这次作答。
答题进度、孩子档案和薄弱记录,都存在当前浏览器里。你可以导出 JSON,也能打印结果或备份档案。换设备、清理浏览器数据之前,记得先备份。
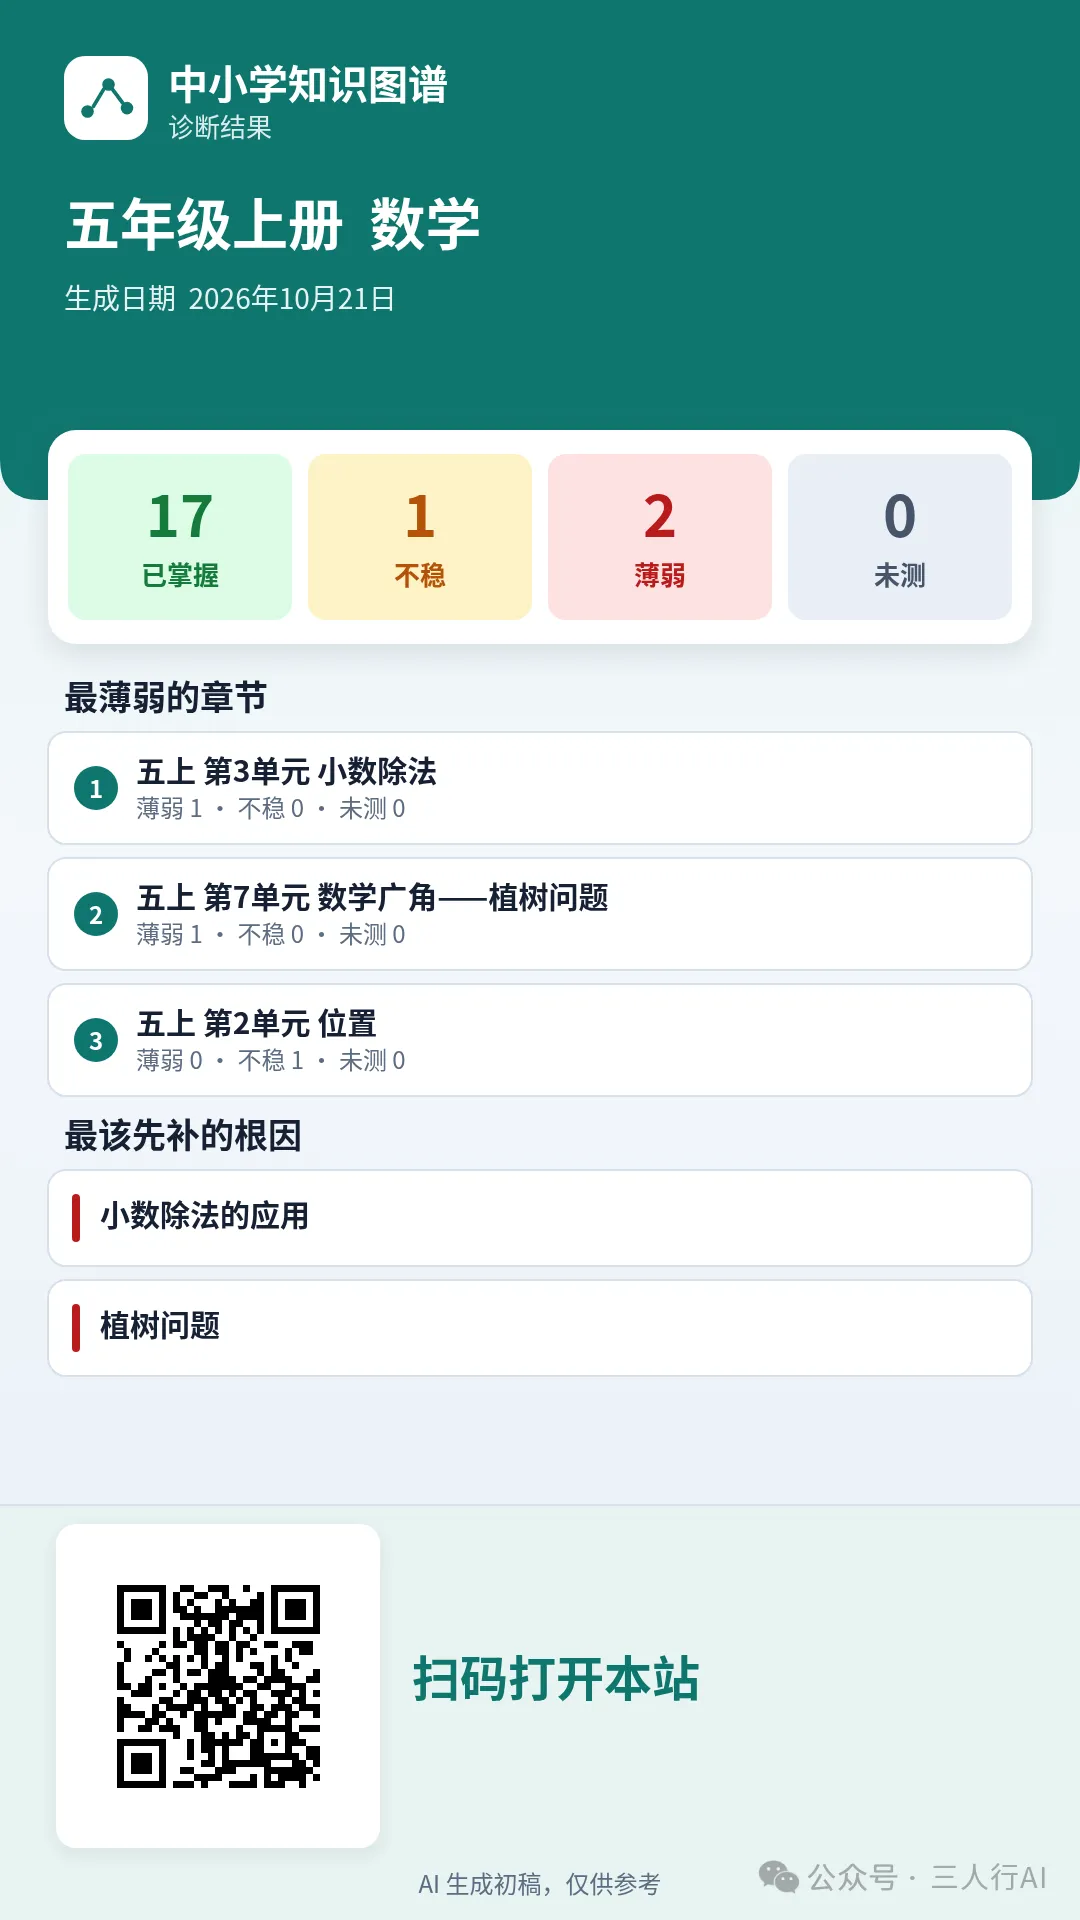
数学诊断的竖版分享图
分享图也是在浏览器里生成的,尺寸是 1080×1920。测了哪个范围、各类状态有多少、部分薄弱点是什么,图上都能看到,还带着站点二维码,但不会显示孩子姓名。
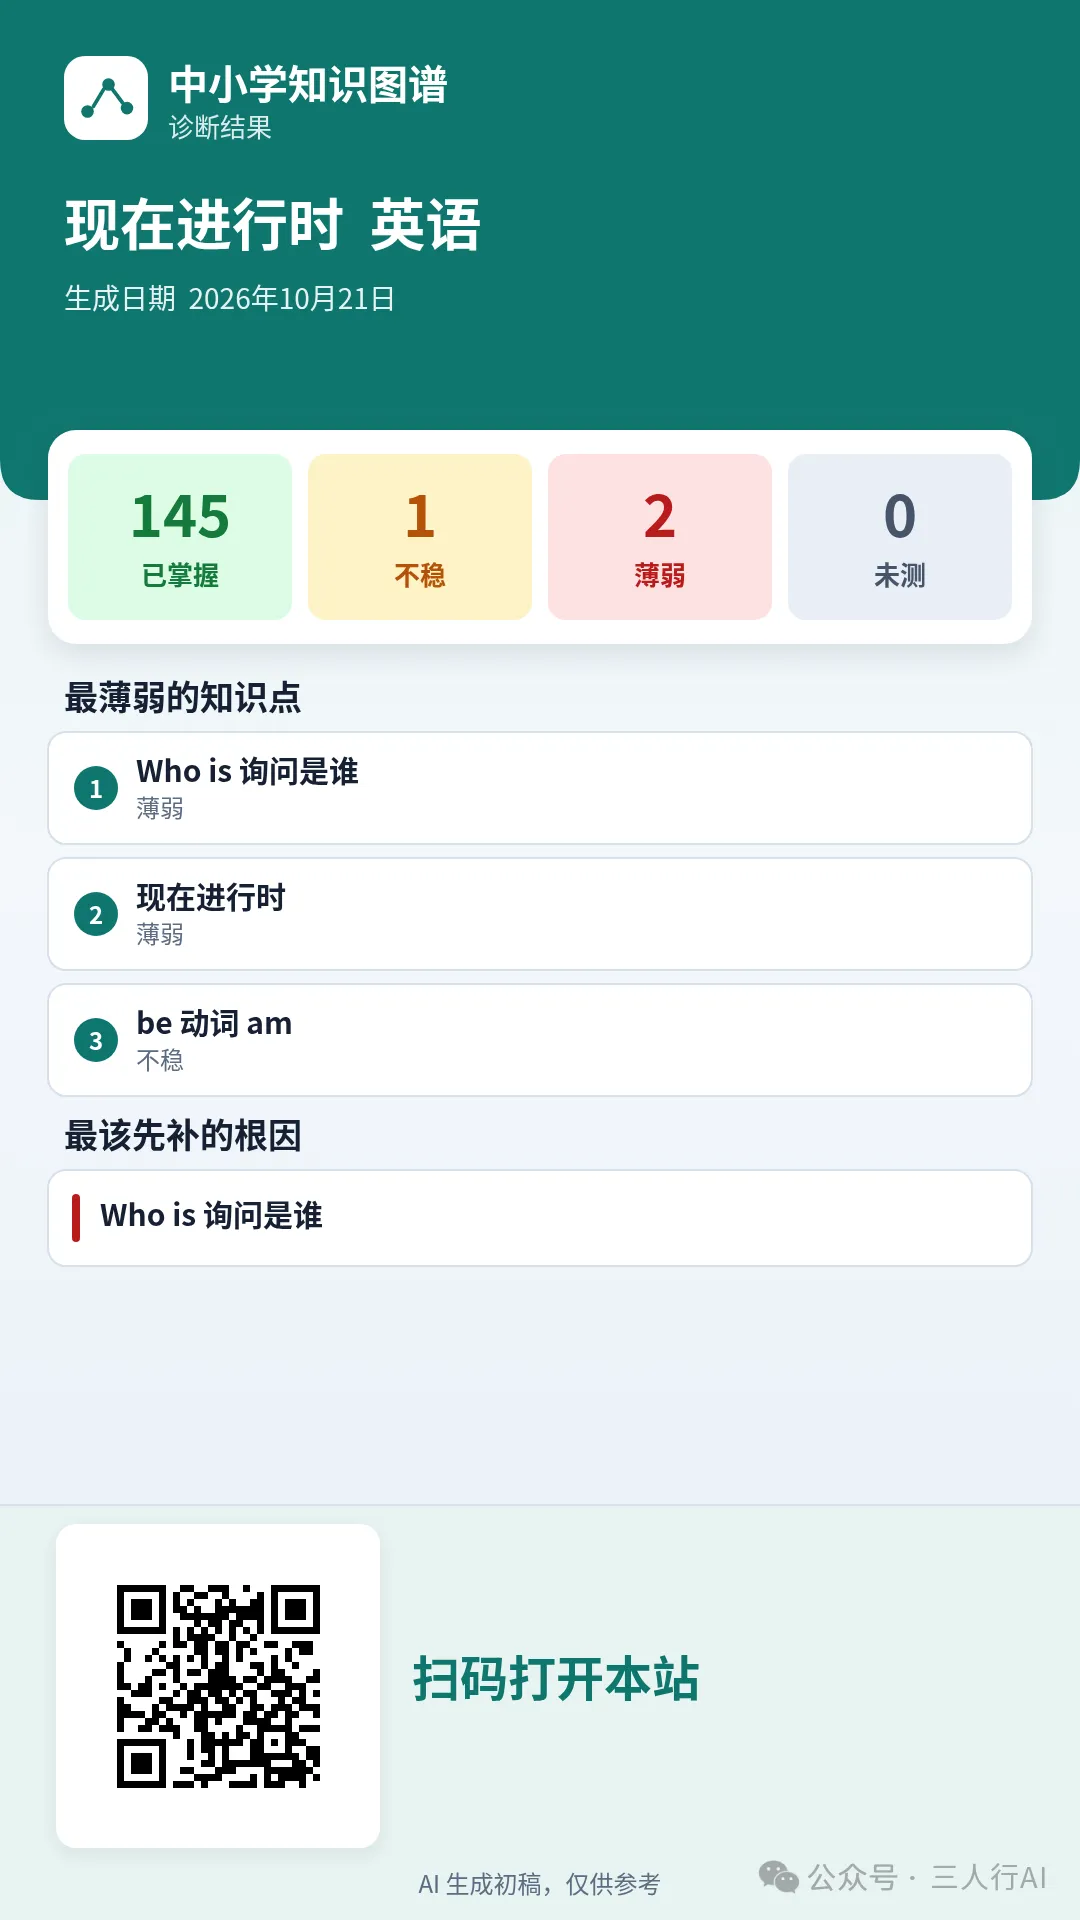
英语诊断的竖版分享图
手机上可以长按保存。要和另一位家长或老师讨论时,把这张图发过去,对方能看到这次测了什么、哪里还不稳,沟通起来会具体一些。
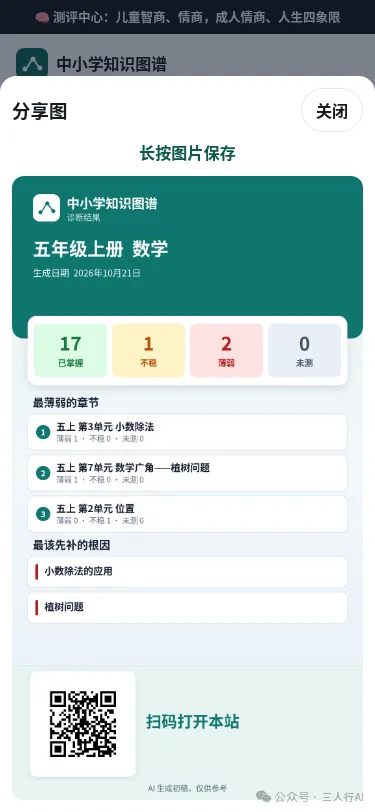
手机端保存分享图的弹层
这里也得分清两件事。答题记录保存在本地,页面本身仍会发出网络请求。核对的这个版本已经配了访问统计地址,会发送页面访问等事件。项目说明不会收集孩子昵称和答题内容。如果你打算自己部署,还是要看一眼实际的统计配置。
05
从哪里开始,目前覆盖哪些内容
直接打开 math.pansgo.com(https://math.pansgo.com/) 就能看,也有 GitHub Pages 备份(https://xiaoyang111222.github.io/cn-math-taxonomy/)。首页可以选学科和年级,再进入知识图谱或诊断工具。想先看看答题过程长什么样,可以点开配方法演示(https://math.pansgo.com/diagnose/?target=cnm_221&demo=1)。
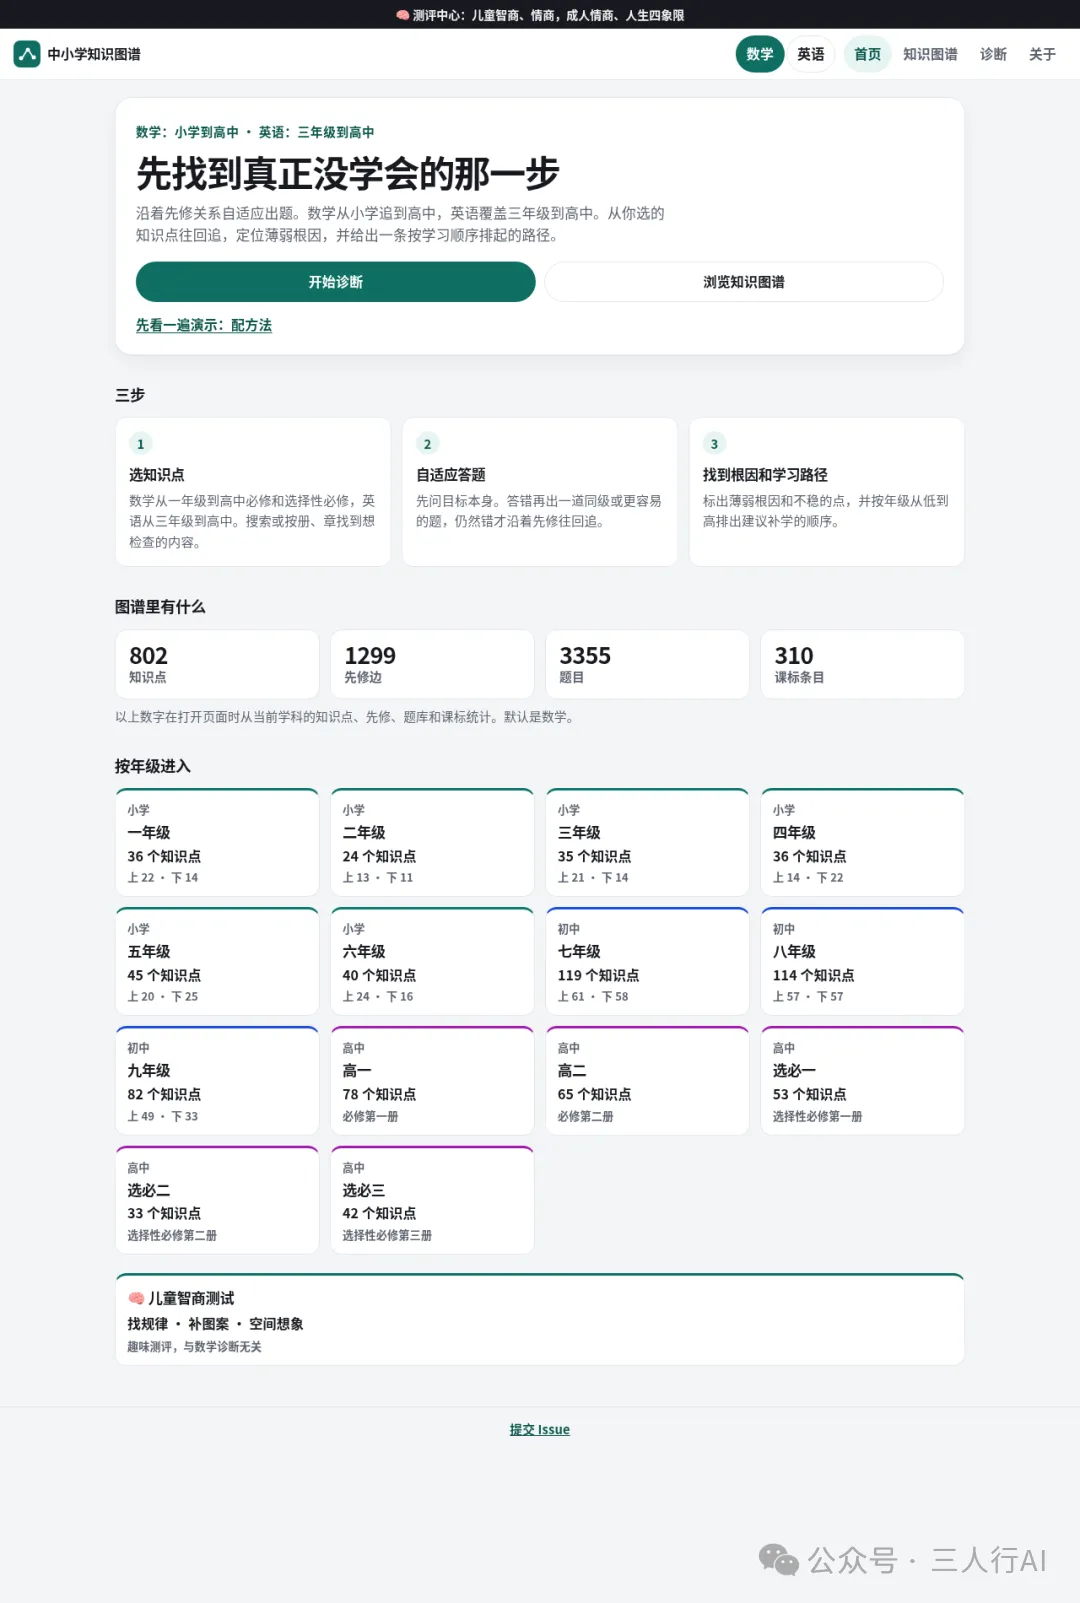
项目首页,提供学科、年级和诊断入口
按 2026 年 11 月 2 日核对的那次提交,数据文件里一共有 2,997 个知识点、4,456 条先修边、12,135 道题。先修边就是知识点之间的前置关系。这些数字说的是收录量,不代表每条内容都已经过老师审核。
数学从小学一直到高中必修和选择性必修。比如下面这两张图,看的就是高中函数和导数附近的知识关系。你可以先找找,正在学的那一块有没有收录。
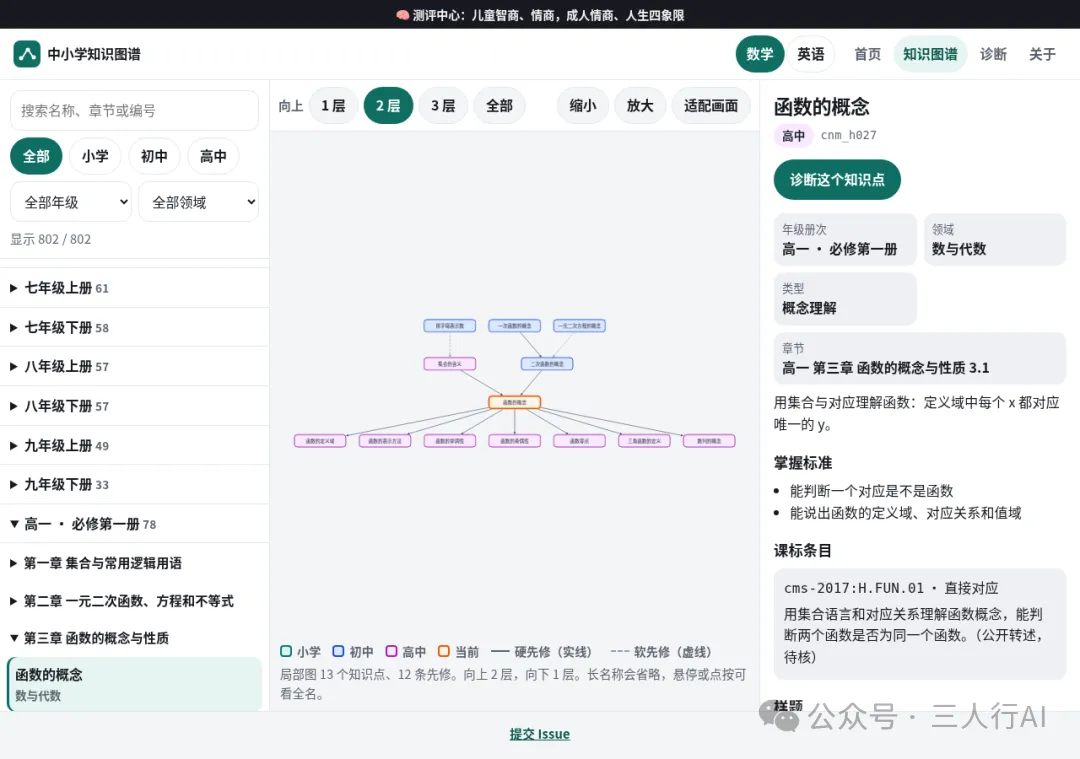
高中函数概念附近的先修关系
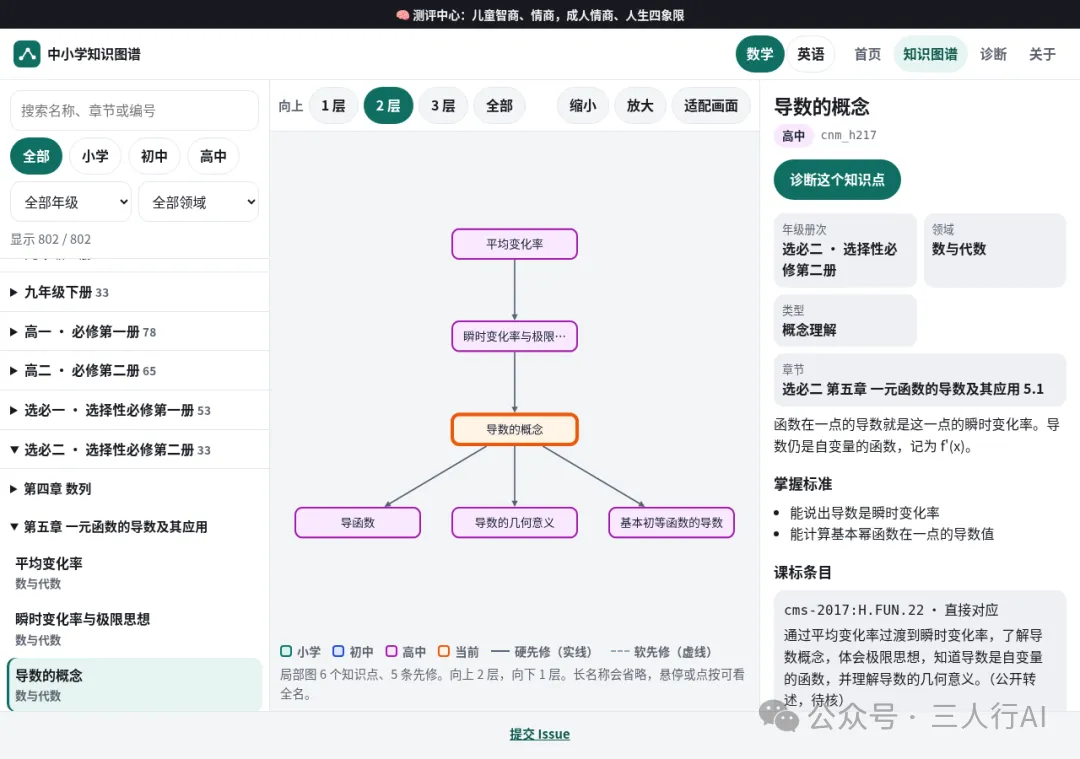
选择性必修中导数概念的局部图谱
英语从三年级到高中,目前没有听力、口语题。语法也能放进图谱里看,比如初中的现在完成时、高中的虚拟语气。
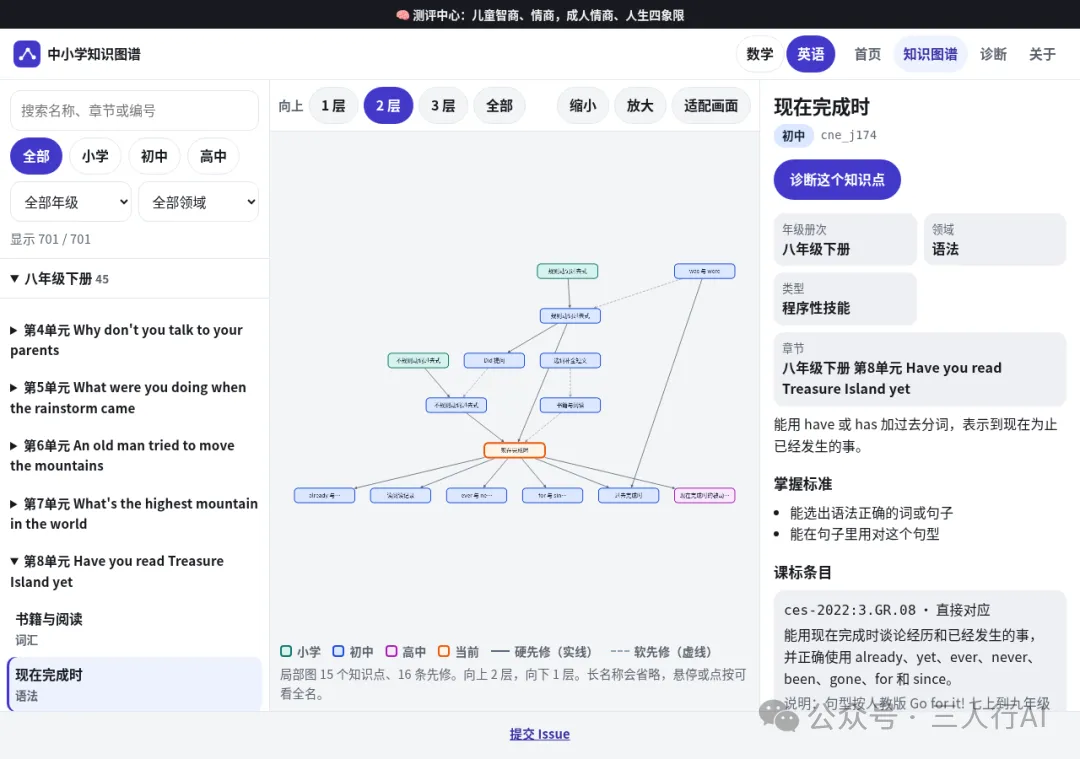
初中英语现在完成时的知识图谱
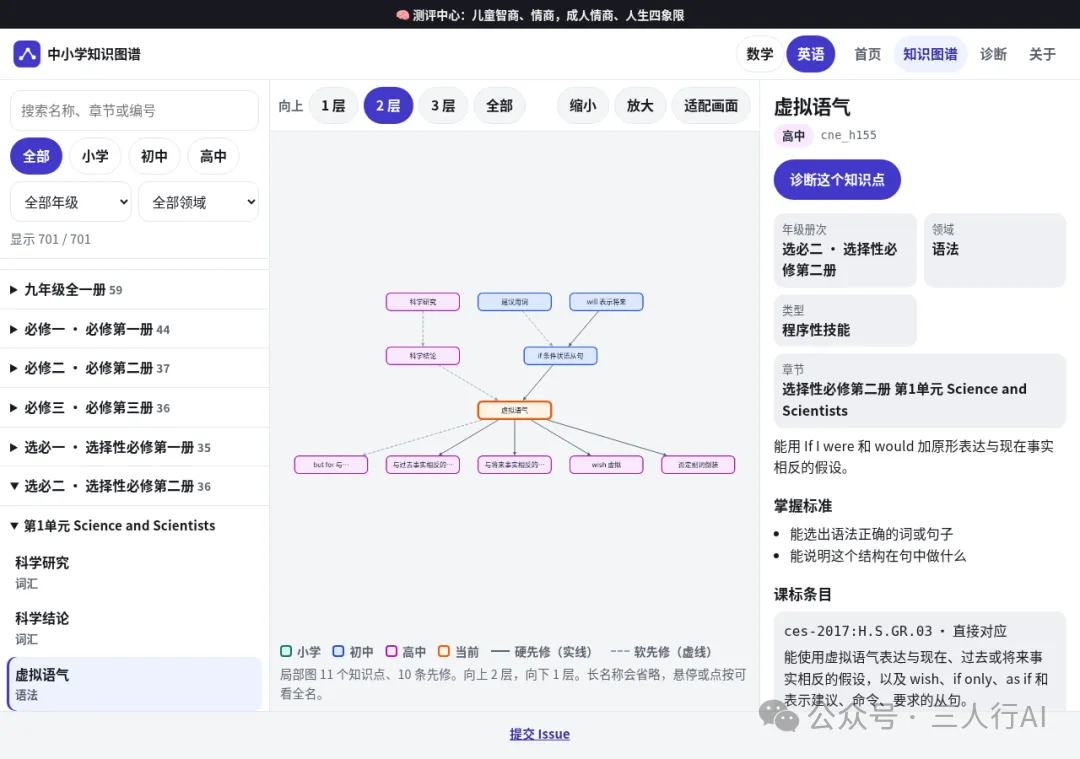
高中英语虚拟语气的知识图谱
其他学科的年级范围要分别看。物理有初中和高中;语文、科学、道德与法治主要是小学内容。历史是初中七至九年级,地理是七至八年级。开始测之前,先确认你需要的内容在不在。
06
这些功能是怎样实现的
看完怎么用,再来拆一拆它背后的做法。项目先把知识点和前后关系整理好,页面读进这些数据,再根据你怎么答题,按规则决定下一道问什么。
先把知识点和前置关系存下来
topics.json 里放的是一个个知识点。名称、年级册章、通俗说明、掌握标准和诊断题,都放在对应记录里,还可以带上课程标准映射。每个点有一个稳定 ID,页面、题目和知识关系就靠这个 ID 对上。
dependencies.json 里放的是连线:哪两个知识点相连、关系有多强、为什么要这样连。topicId 依赖 prerequisiteId,意思就是学前一个知识点之前,需要后一个。hard 表示较强的前提,图上画实线;soft 表示学过会有帮助,但不是硬门槛,图上画虚线。
各科的图谱是分开的。物理和科学里,可以用 mathLinks 标出相关的数学知识,但这种链接不算本学科的先修边。测物理时,不会因为有这个链接就自动跳去测数学。
根据作答,在两条分支之间选择
它先问你选中的知识点。答错了,或者选了“不会”,就找同级或更低难度的题再确认一下。确认题还错,才记为薄弱,然后往前查。查的时候,先问 hard 关系里的直接先修,再问 soft 关系里的。
如果一直答对,就按另一套规则走。默认要连续答对 3 题,页面也能选 2、3、5。题库没那么多题,就按实际能出的数量来判。达到要求后,这个点记为掌握,前面还没测过、也没判定的祖先知识点,可以记成“掌握(推断)”。已经直接答过题得出的结果,不会被这种推断覆盖。
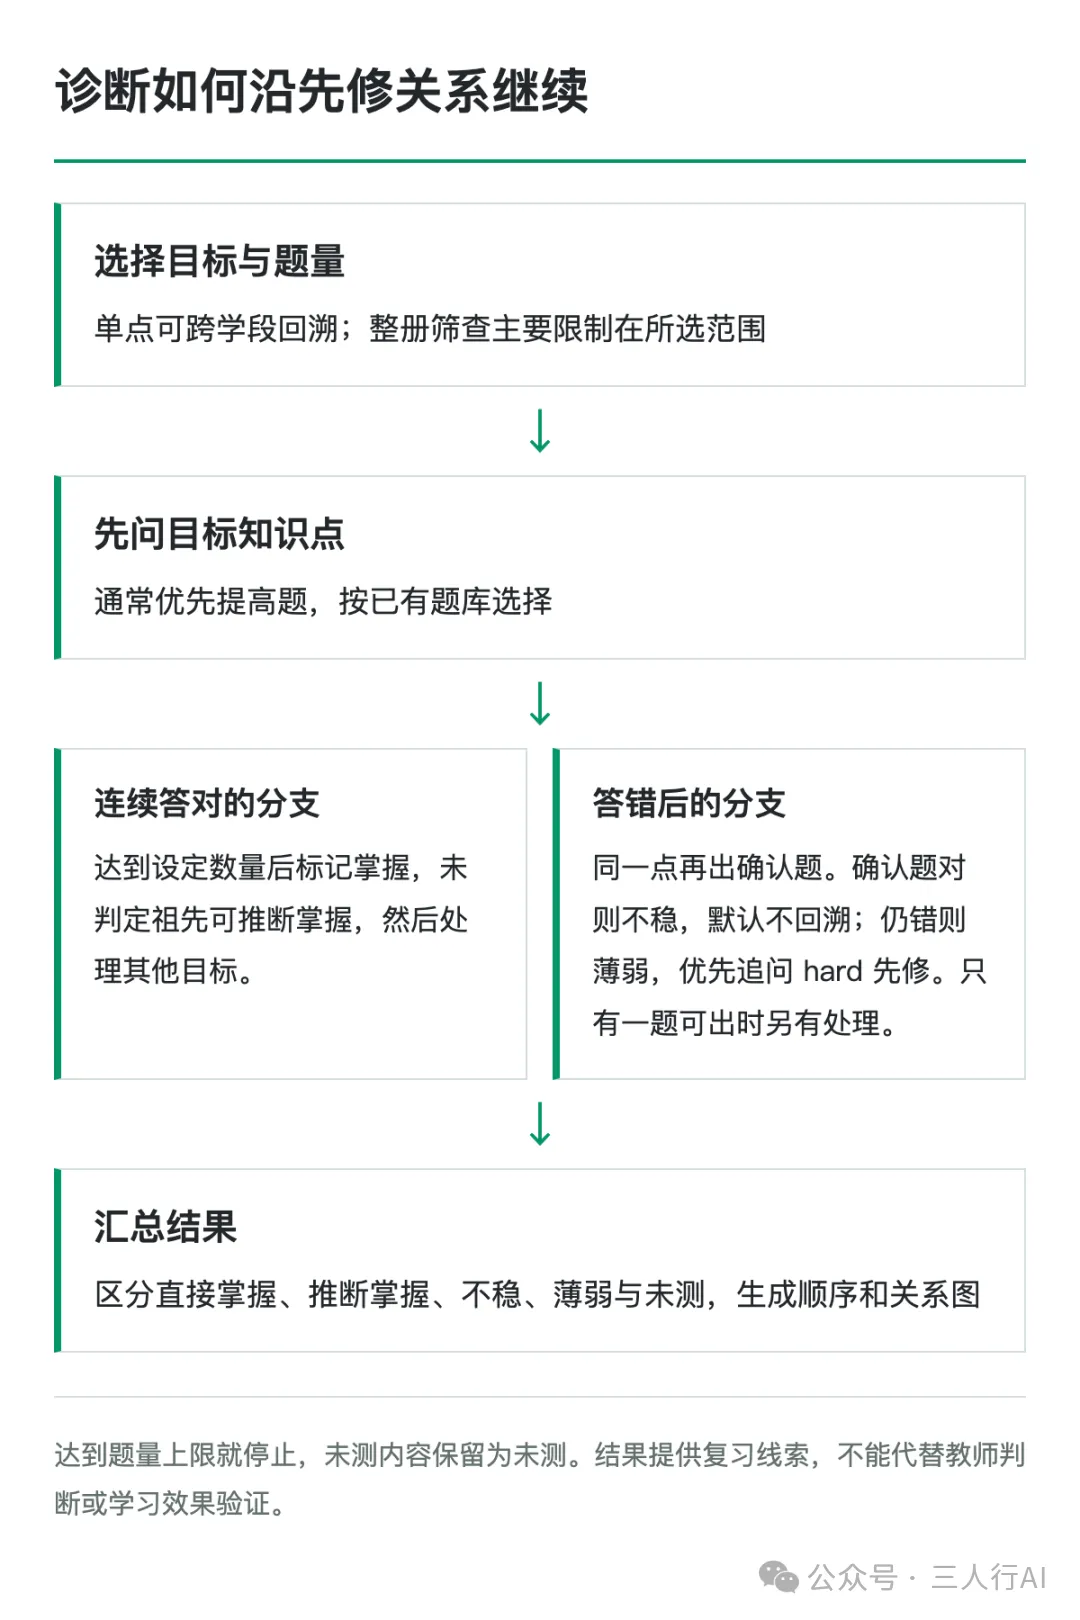
诊断选题、状态判定与先修回溯的流程示意
所以,答错后的确认题,和连续答对后的掌握判定,走的是两套规则。如果刚答错一题就碰到题量上限,会暂时记为薄弱,同时告诉你还没复测。看结果时,要留意哪些是直接测出来的,哪些是推断的,哪些还没测。
静态页面加规则引擎,在浏览器里运行
这套页面用 HTML、CSS、JavaScript 和 JSON 做成,不用额外配服务端数据库也能跑。图谱交给 Cytoscape 和 dagre 来画,诊断规则放在纯函数引擎里。页面读数据、显示结果,浏览器本地存储负责记住答题进度,各自做各自的事。
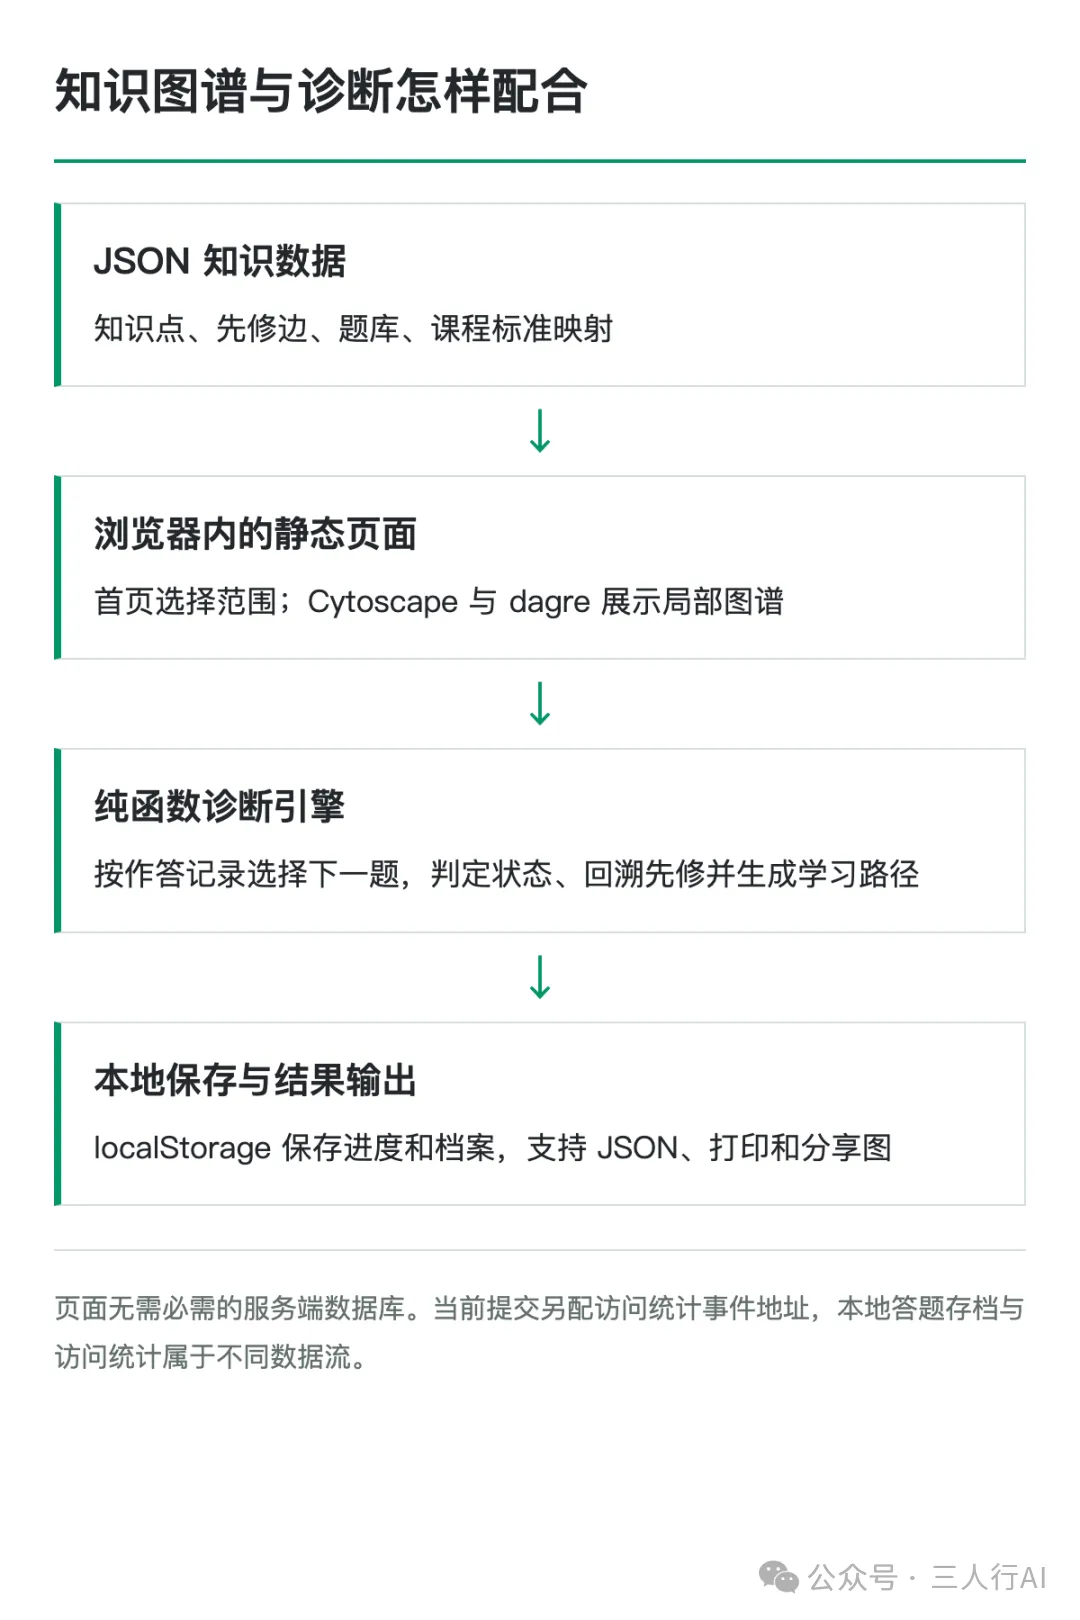
知识数据、静态页面、诊断引擎与本地存储的关系
如果你想自己跑,在项目根目录启动一个静态服务器就行。页面靠 fetch 读数据,直接双击 HTML、用 file:// 打开,不适合这套做法。
git clone https://github.com/xiaoyang111222/cn-math-taxonomy.git
cd cn-math-taxonomy
python3 -m http.server 8000
然后用浏览器打开 http://localhost:8000/。/explore/ 是知识图谱,/diagnose/ 是诊断页面。英语等学科用 subject 参数选择,具体填什么,以项目页面为准。
想检查数据或跑引擎测试,也有现成命令。
python3 scripts/validate.py
node tests/test_engine.js
前面那次固定提交的诊断引擎测试,跑下来是 92 项通过、0 项失败。回溯顺序、题量限制、作答重放及真实数据结构,都有测试覆盖。它能说明程序有没有按规则做事,至于题目出得好不好、孩子学得有没有进步,还得另外验证。
07
真正用起来,还需要老师和家长把关
想试的话,可以就从孩子正在学的一个知识点开始。看看题目合不合适,答错后往前查的理由讲不讲得通,再选一块复习。遇到不合理的题,先改题或改判,不要因为一次“不稳”或“薄弱”就给孩子下结论。
里面不少先修关系和诊断题是 AI 生成的,掌握标准也需要审核。部分小学、初中数学题做过自动重算或独立复核,高中和英语还没有同等程度的盲解验证。自己的校验式算对了,也不能保证题意、答案和干扰项就都没问题。
教材目录和课程标准的来源,项目里有保留,也标了哪些地方“待核”。有些条款对过官方目录,有些用的是公开转述或第三方目录。exact、inferred 说的是怎么映射,不能直接理解成已经审核通过,更不能把所有映射都说成官方认证。知识点之间该不该连、关系有多强,也得请一线老师看。
使用范围也要看清。知识图谱、题库、诊断代码与文档采用 CC BY-NC 4.0,可以按协议用于非商业学习、教学和研究,要署名并保留来源。付费课程、收费服务或售卖题库等商业用途,需要另行授权。用到的图形库则仍按各自的 MIT 许可来。
对家长和老师来说,它能帮你把“接下来补哪里”说得更具体,拿着结果和孩子一起看,再决定怎么复习。对开发者来说,知识数据和诊断规则分开,也方便研究和复用。接下来更值得看的,是知识关系经过老师审核后,孩子实际用起来有没有帮助。
我是山行AI,持续分享工具与技术资料。
来源与声明
依据 cn-math-taxonomy 项目(https://github.com/xiaoyang111222/cn-math-taxonomy)、诊断说明(https://github.com/xiaoyang111222/cn-math-taxonomy/blob/main/diagnose/README.md)、诊断引擎(https://github.com/xiaoyang111222/cn-math-taxonomy/blob/main/diagnose/engine.js)、课程标准映射(https://github.com/xiaoyang111222/cn-math-taxonomy/blob/main/docs/standards-mapping.md)及数据文件整理。数据快照对应提交 63757ad869076219fcdc047934db76198ff365f5,截图为项目公开示例。
本文由山行整理自 cn-math-taxonomy(https://github.com/xiaoyang111222/cn-math-taxonomy),如果对您有帮助,请帮忙点赞、关注、收藏,谢谢~

