机器人跳舞比走路简单:跳舞有教材照着描,走路的数据得自己摔出来
- 2026-11-19 03:27:53
MODEL LAB · 模型实验 · EXP.080
机器人训练数据不够?一枚硬币让数据翻倍
强化学习 vs 模仿学习,两条路撞上同一个问题——附 Mac 可跑的实测代码
|
教机器人,最后卡住的多半不是算法,是数据。这篇讲怎么把一条数据掰成几条用——数据增强。我们试的最小一招:让他一半时间在镜子里练。数据一条没多录,五局全摔的学生站住了两局。往下拆。
老规矩,先对暗号
| 强化学习(Reinforcement Learning,RL) | |
| AMP(Adversarial Motion Priors) | |
| 动捕(Motion Capture) | |
| 模仿学习(Imitation Learning) | |
| 示范数据(demonstration) | |
| 数据增强(data augmentation) | |
| 对称增强(symmetry) | |
| 域随机化(Domain Randomization,DR) | |
| 策略网络(policy) | |
| 遥操作(teleoperation) |
EXP.01 | 我们是这样训走路的 |
先看一张我们训练时的画面——一群替身同时上场,每个都在摔、在爬、在挪。
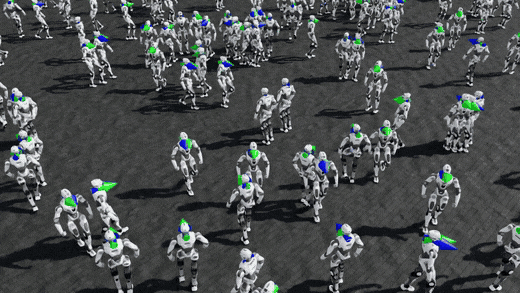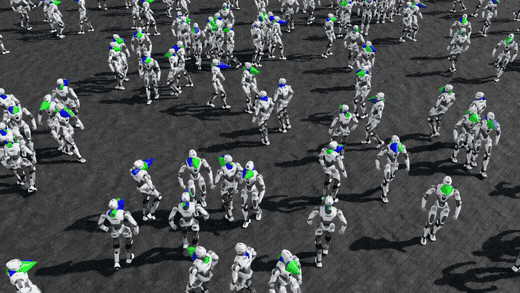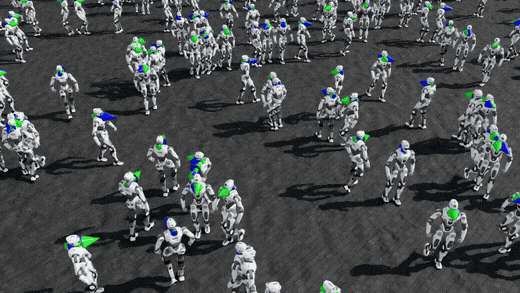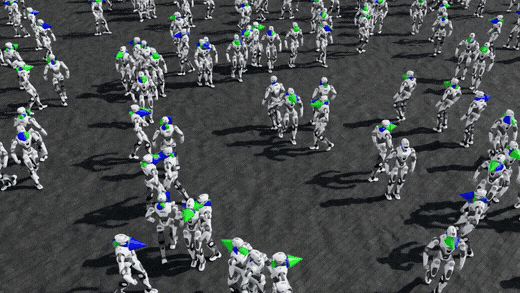
图 1 · 我们训 T800 走路的日常:一群替身同时在场上摔、在学(某次 AMP 训练实录)
这是教 T800 学走路。强化学习的思路一句话就能讲完:不教他怎么走,只教他走得好不好。剩下的路,他自己摔出来。
打分表是这么写的——下了指令「前进 0.8、左转 0.3」,走出对应速度的加分;身子歪了、动作抖了、脚打滑了,扣分;摔倒,这一局直接结束,从头再来。单靠这张表还不够严:他很快就会学出些歪姿势蒙分。所以又请了个裁判,AMP——拿真人动捕当标准答案,动作不像人就额外扣分。两道关卡一起上,糊弄不过去。
然后是最痛快的部分:上量。云端的 4090 上,4096 个替身同时上场,每个替身走 24 步,一轮攒下近十万次动作——摔了的拉倒,换一批接着来;好的动作多来点,差的动作少来点,网络朝高分方向改一小步。每轮三秒上下,凌晨开跑,两万轮跑完,一个跟头没栽。
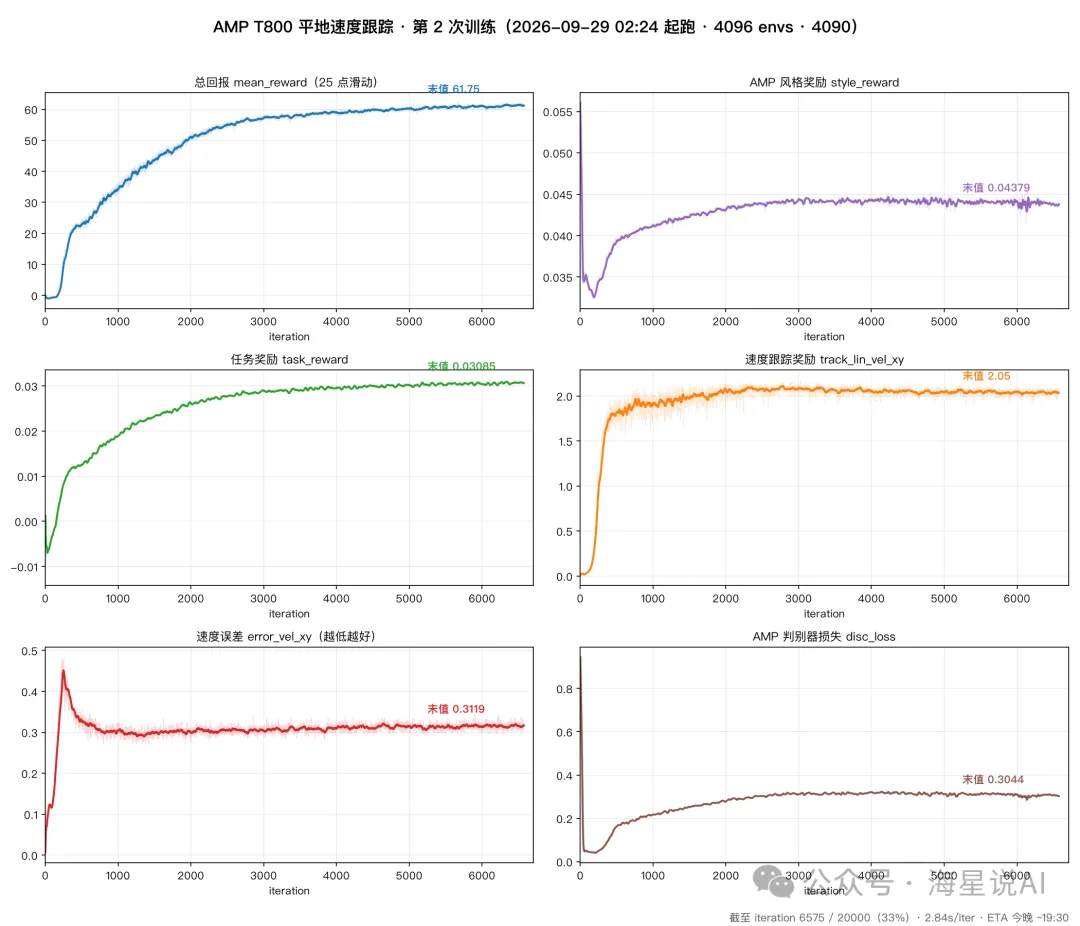
图 2 · 那次训练的成绩单(中途快照):两万轮跑到第 6575 轮即三分之一时,总回报已从 0.015 爬到 61.75
这里有个容易忽略的事实:教走路,我们一条数据都没录过。打分表写得出来——走多快、身子平不顺、摔没摔,全是规则。规则能打分,强化学习就能自己摔自己学:每一轮那近十万次动作,就是十万条训练数据,当场生、当场用。
OBSERVATION · 实验发现
走路的数据是练出来的,不是录出来的。
EXP.02 | 轮到跳舞,跳舞反而简单 |
跳舞不一样——不一样在打分表写不出来了。「这支舞跳得像不像」,怎么用规则打分?姿态分?节奏分?哪只手该在哪一拍抬起来?规则一复杂他就开始钻空子,这个系列的老读者都见过他的本事。
所以跳舞换教法:模仿学习。给一份教材——真人动捕录下来的示范——他跟着跳,每一帧跟教材差多少就扣多少分。教打拳那次我们就是这么干的:万代动捕库里真人出拳的七秒录像当教材,逐帧比对。下面这条就是一份教材的样子:官方动捕舞蹈,重定向到机器人身上。
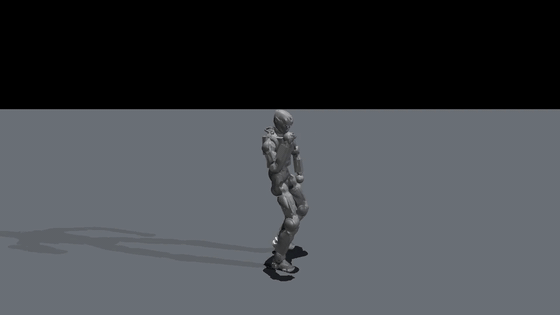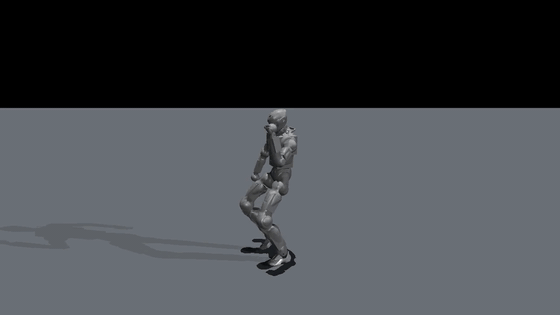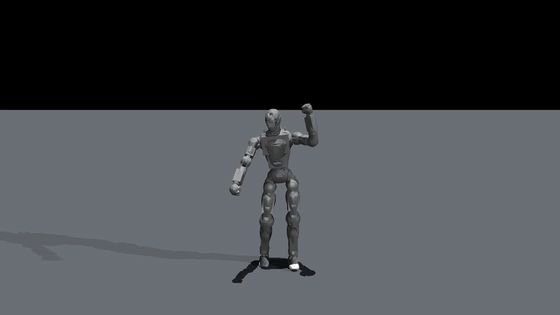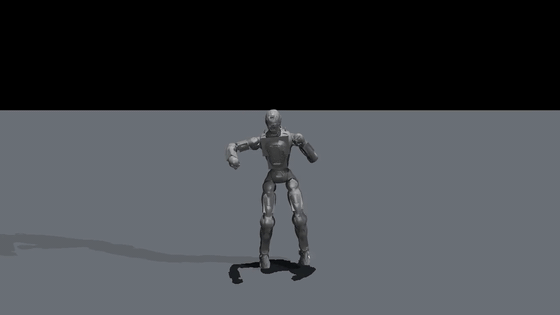
图 3 · 一份「示范数据」长这样:官方动捕舞蹈重定向、本机渲染——模仿学习要吃的教材
两套教法摆在一起,有个反直觉的事就浮出来了:有教材的跳舞,比没教材的走路好学得多。
模仿学习 vs 强化学习 · 本系列实测对照
道理在「每一步有没有答案」上。跳舞的每一帧都有教材对答案,分数是稠密的,照着描就行;走路没有教材,只有终点处的几条规则,中间那几万步怎么迈,全靠试错自己长出来。描红贴着字描,书法要自己写——对人,跳舞比走路难;对机器人,正好倒过来。
而且倒过来的这头更值钱。轨道是钉死的表演,地图是即兴的底座:你想看的那些画面——走到桌边、拿起杯子、边走边挥手——中间的移动、站稳、衔接,全踩在「任给指令都走稳」这块地基上。会跳一支舞的机器人有很多,怎么指挥都走得稳的,才是往后所有任务的底盘。
但地图有地图的代价。跳舞的命门是教材,一条一条录;走路看着不花钱,真要走得又快又好,喂进去的是两万轮、每轮十万次的试错。两条路最后撞在同一个问题上:数据,从哪来,够不够。不够,怎么办?
EXP.03 | 数据不够,一枚硬币的用法 |
验证最便宜的答案,我用的是系列里最便宜的学生——Mac 上的小个子 SA01,十二个关节的双足,就是第一课半蹲骗分那位。10 月初,我把当年教他站立的那套基线原样复刻了一遍:300 万步,同一张手写打分表。同一套代码,当年他还能半蹲蹭到分,这次五回全摔——同配置不同随机性能差多远,这就是第一课。
结果比当年还直白:奖励稳在 1.2 上下(终值 1.24),终评五回合,五回全摔,撑得最久的一局 1.17 秒。分数不难看,人一直在摔。这份基线留在这儿,就是要给他上一堂新课:不改打分表,不改网络,不加算力,只改一件事——让他学会从镜子里看自己。
分三步讲,看完你能在自己电脑上复现。
第一步,想明白为什么镜像合法。SA01 是左右对称的:左腿六个关节,右腿六个关节,长得一模一样。那么「左腿前迈、右腿支撑」的一步,整体翻个面就是「右腿前迈、左腿支撑」——物理上同样成立,同样该得分。真实世界里拍一条这样的示范要人录一遍;镜像世界里,每条经验自动自带一个孪生兄弟。
第二步,把「翻面」翻译成机器人能读的数。机器人不懂什么叫镜像,他只认自己那 31 个输入:12 个关节角、12 个关节速度、4 个数的姿态朝向、3 个轴的角速度。翻面就是把这套数重新排列——左腿六个关节的数跟右腿互换位置;横滚、偏航这类「左右分家」的角度换成反的;朝向和角速度里管左右的分量取反、管前后的保留。十来行代码,纯数学,不碰物理仿真器。
第三步,掷硬币。每个回合开始前掷一次:正面,正常视角;反面,镜像视角。神经网络根本不知道镜子的存在——他只是有时活在一个左右互换的世界里,照样学站立。唯一要补的一手:他在镜像视角里决定「抬左腿」,发出去之前得翻回真实空间去执行,不然腿就抬错了。
说句实话:掷硬币版不是把每条经验存成两份来学,而是同样的步数预算里,让他一半时间活在镜像世界——效果等价于每条经验用两次。
就这么多。300 万步重跑,其他配置一个字没动——网络还是那两层 128,学习率还是 3e-4,打分表还是原来那张。终评五局:两局站住,满存活五秒,重心高度 0.84(标称站高 0.82 附近);三局还是摔,0.58 到 1.78 秒。基线那组是零局站住。
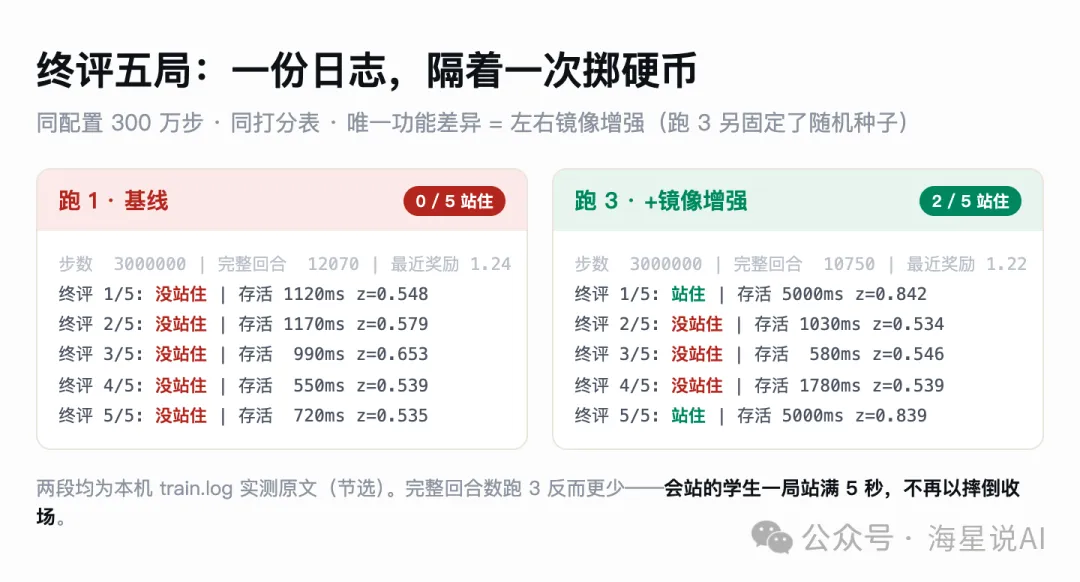
图 4 · 跑 1 与跑 3 终评对比:配置唯一差异是镜像增强——种子处理另有差异,见下文丑话
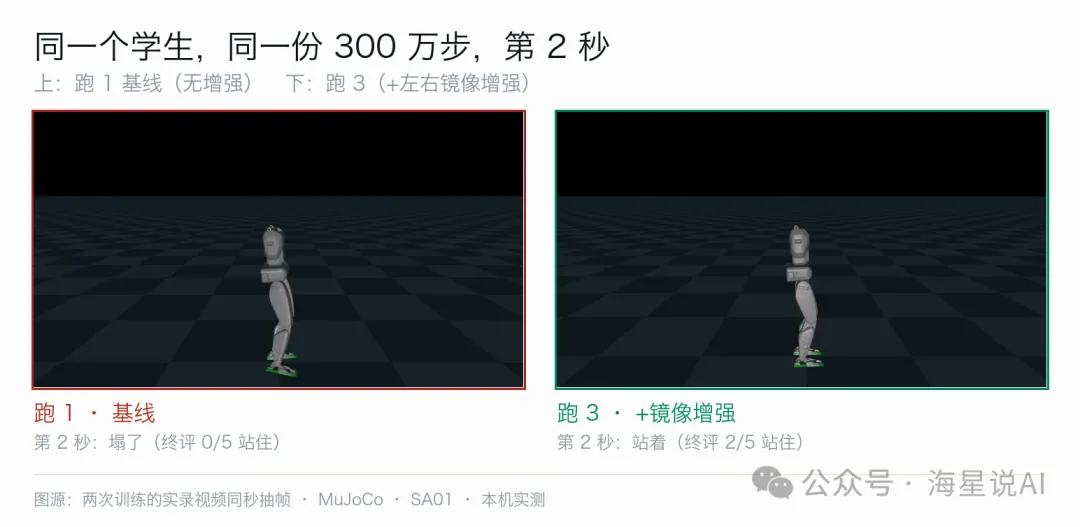
图 5 · 五连摔(跑 1)与站稳(跑 3)同一时刻画面对比
还有个反着来的细节我盯着看了半天:跑 3 的完整回合数反而更少,10750 对 12070。想想就通了——基线的学生每局都摔,回合短,刷得快;会站的学生一局站满五秒,回合数自然少了。
OBSERVATION · 实验发现
回合数下降,多半是因为他不再以摔倒收场。
丑话说在前面:这是单次对照,跑 3 还固定了随机种子(跑 1 的原始代码没固定),两组严格说不是种子级对照。我自己另一条实验线上试过同配置双种子,结局天差地别,所以我把这组数字当「方向对了的证据」,不当「定论」。机制本身是干净的——占的是物理世界对称性的便宜,这个不会骗人。
EXP.04 | 数据增强是个大家族 |
这一招的学名,叫数据增强:一条数据,加工出好几条合法数据——用对了地方,一下就能白嫖好几倍。对称增强翻的是「左右」,×2,是这家族里最小的一招。往大了去,路子一层比一层野。
换着花样看同一条数据(×几十)。同一个动作,把仿真场景里的地面摩擦系数改一改、质量加一成减一成、光照换个角度、相机挪个位置——对机器人来说,每换一版就是一条新数据,而且这些版本将来真机上都可能遇到。这就是域随机化:训练时故意把世界搅乱,让他什么世面都见过,真机上的「意外」就成了「复习」。第一节那张训练画面里,这些事一直在发生——T800 那次训练里就有这一族:故意推他一把、给他换地面,练的就是「被使绊子也不倒」。
把几条数据拼成全新的(×250)。拼装路线的代表作是英伟达 2023 年的 MimicGen:拿少量人类示范,自动拆解、重组、插值,在仿真里拼出全新的完整示范。论文的官方数字:约 200 条人类示范,生成超过 5 万条,覆盖 18 个任务——一条变 250 条。更狠的是质量:十个真人示范生成两百条,训出的成功率 79%;两百条全真人示范,84%。几乎打平,人力只剩二十分之一。这条管线现在已经被集成进英伟达自家的 Isaac Lab。
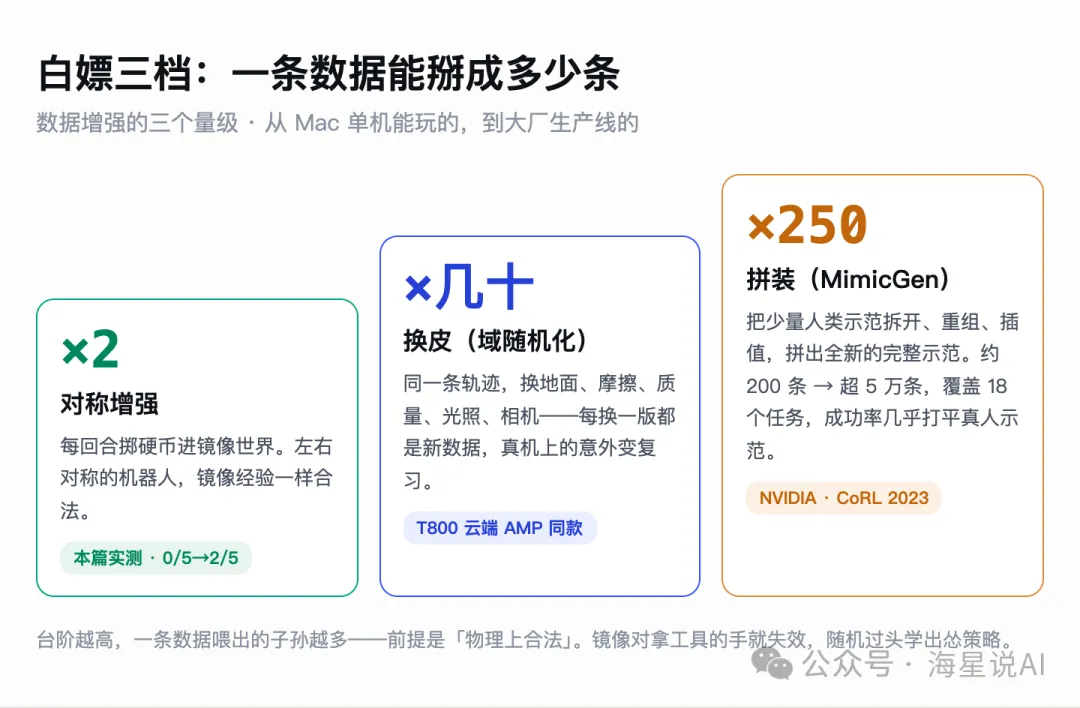
图 6 · 数据增强三档:对称 ×2、换皮 ×几十、拼装 ×250
这门功课,恰恰是穷人的武功:云端 4096 个替身是土豪的玩法,数据增强是单机玩家的活法。我这台没有显卡的 MacBook,靠一枚硬币先把数据翻了一倍。
EXP.05 | 为什么数据增强不是省钱技巧,是必修课 |
因为这个行业的数据账,已经缺到不好笑了。
口供需参考。信通院《具身智能发展报告》说,要实现物理智能的涌现,「至少需要百万小时、甚至千万小时的高质量真实行为互动数据」。银河通用的创始人王鹤给的数字更狠:面对实现通用智能所需的上万亿条数据,全球当前的采集规模「仅停留在百万级别」——中间差着五六个数量级。
智元合伙人姚卯青(现觅蜂科技 CEO)的口径居中:达到开箱即用的类人能力,「大概需要一亿小时量级的数据」,而全球有效的具身数据只有几十万小时。单位不同,方向一致:缺口是以「数量级」计的。
采集员们干的正是遥操作——握着手柄,一条一条带。把各家口径按「一小时折几十上百条」粗算,需求落在十亿到万亿条之间。取个保守的中间值,百亿条,算笔人海账——智元数采中心的熟练采集员,一天能采约 200 条有效数据。按这个产能,百亿条需要一万四千个人,不吃不睡,干满十年。这不是哪一家的产能问题,是全行业的人效天花板。
现实里大家确实在往里堆人。京东发动过十万名员工加五十万外部人员搞数据采集;湖北的人形机器人创新中心一天产出 2.4 万条,年目标近千万条——离百亿条还差着一千倍。不是他们慢,是目标实在太大。真机数据还有个市价:按小时卖,500 到 1000 元一小时。
人海填不满的坑,主要就剩两条路:要么合成,要么增强。银河通用自建的合成数据基建是百亿级;MimicGen 是增强一路的招牌——而它扩增的原料,就是示范数据。
对单机玩家其实还有第三条路:直接用别家开源的——智元开源过百万条真机数据集 AgiBot World,国际上 Open X-Embodiment 汇了全球 34 个实验室一百多万条轨迹,都能直接下。行业主线则是把增强当真机数据的放大器:部署、回流、增强、再训——增强不替代真机,是把每一条真机的价值乘上去。
回到我这台 MacBook。MimicGen 那样的拼装我还没玩到,域随机化在云端见过大场面,最小的一档是亲手验过的:一枚硬币,数据翻一倍,0/5 到 2/5。穷人武功的第一课,先从把每条数据用两次开始。
EXP.06 | 算账 |
三笔。
最小的一招也有用。一枚硬币,零成本,零改动物理、打分表和网络,0/5 到 2/5。这不是「对称增强很神」,是「数据这件事很值」——同一个学生、同一张考卷,多喂一倍视角,这组数字里成绩就动了。
增强有边界,得知道失效在哪。镜像增强的前提是任务本身左右对称:站立、行走、跑步,都满足。但让单手拿螺丝刀的机器人去拧螺丝,左右就不对称了,镜像世界里的「左手拧」是非法数据,这一招立刻失效。域随机化也有过头的时候——随机幅度拉太大,机器人见到的全是「不可能世界」,学出来的策略反而怂。数据增强是物理合法性的搬运工,不是无中生有的印钞机。
这招不是我发明的,是官方同款。跑 3 的镜像代码,思想移植自众擎开源仓库 engineai_rl_lab 里的 symmetry.py——就是 T800 云端 AMP 训练用的那个仓库。我在 Mac 上给 SA01 玩的,和生产线上给 T800 用的,是同一族手艺。大厂小作坊,缺数据的命是一样的。
EXP.080 · 第四句
一条数据最大的浪费,是只让它教机器人一次。
想自己跑一遍的,后台回复「硬币」,领取镜像增强复现包——跑 1 基线版和跑 3 镜像版两份完整代码(Mac 上装好 MuJoCo 就能跑,没有显卡也行)、两次终评的完整日志、数据增强三档对照表。同样的 300 万步,你也掷一枚硬币试试。
(声明:本文不是软广,与文中提及的公司均无商业合作。众擎不认识我,英伟达也不认识我。)
REFERENCES · 参考来源
[1] 跑 1 / 跑 3 实验:本机实测(MacBook,MuJoCo + stable-baselines3 PPO,网络 [128,128],学习率 3e-4,各 300 万步;跑 1 未固定随机种子,跑 3 固定 seed=42,除此之外功能差异仅镜像增强;跑 1 终评 0/5 站住(存活 0.55-1.17s),跑 3 终评 2/5 站住(满存活 5s,z=0.842/0.839)——全部数字出自两份 train.log;终评判据:存活满 500 步即 5 秒且最终重心高度 z≥0.75 记「站住」;跑 3 日志中段有一次进程中断重启,seed 固定故前后两段完全一致)
[2] 走路训练与教材:众擎 engineai_rl_lab(AMP 拟人行走任务,BSD-3;图 1 为 0918 run 训练实录,图 2 为 0929 起跑 run 的曲线中途快照,两次不同训练);对称增强思想出处 tasks/locomotion/amp/mdp/symmetry.py;图 3 动捕舞为众擎官方舞蹈动捕数据、本机 MuJoCo 渲染;
[3] MimicGen: A Data Generation System for Scalable Robot Learning using Human Demonstrations(NVIDIA,CoRL 2023,arXiv 2310.17596)——约 200 条人类示范生成超 5 万条、覆盖 18 个任务、单任务最少 10 条可起步; Square D0 上 200 条生成数据训策略成功率 79% vs 200 条真人示范 84%(生成组源自 10 条真人);摘要与项目页(mimicgen.github.io)逐字核对;已集成于 NVIDIA Isaac Lab(Isaac Lab Mimic)
[4] 数据缺口口径:中国信通院《具身智能发展报告(2025年)》(「至少需要百万小时、甚至千万小时」);王鹤(银河通用创始人):「上万亿条」出自 GTC 2026 演讲(智东西 2026-03-16 报道),「采集规模仅停留在百万级别」出自科创板日报 2025-06-29 采访;同批报道提及银河通用自建百亿级合成数据基建;姚卯青(智元合伙人、现觅蜂科技 CEO)甲子光年 2026-06-25(「一亿小时量级」对「全球几十万小时」)
[5] 人海数学的产能基数:智元数采中心熟练采集员「每天重复采集约 200 条数据」(中国证券报 2025-06-19 实探报道,同文:100 多台机器人、每天上万条、累计超百万条);京东 10 万员工+50 万外部采集行动(2026-03,甲子光年 2026-06-25 同文引述);湖北人形机器人创新中心日产 2.4 万条(科创板日报 2026-01-16);数据市价 500-1000 元/小时(甲子光年 2026-06-25,北京人形数采基地);AgiBot World(科创板日报 2024-12-30)、Open X-Embodiment(arXiv 2310.08864:100 万+条轨迹、22 种机器人、34 个实验室 60 个数据集)
[6] 本系列前作:50 号(学站立·钻空子,SA01·手写打分表)、51 号《我教机器人打拳,他比了个心》(T800·走火入魔·万代动捕教材)、77 号《我教机器人跑全马》(T800·AMP 两万轮零翻车);本文 EXP.01/02 为前作简写重述,细节以原篇为准
本文图表由代码绘制,画面截图与动图为本机仿真/训练实录,无 AI 生成图片;文中全部数据均经人工核对。
LOG END · 记录完毕
这个系列教过他站立、打拳、跑全马,这次教他省钱。
关注 · 看他的下一个动作

