MaD-RSI:利用模型之间的分歧做教材,单套 Harness 大幅削减训练 Token
- 2026-11-22 01:18:20
论文精读 · AGENT 自进化
模型不是优化目标,
而是优化证据
一篇把「模型间差异」从考核指标改写成训练信号的论文
——以及它顺手改掉的那套评价体系
递归自我改进(Recursive Self-Improvement,RSI)这两年在 Agent 上最实际的落点是 harness:不动模型参数,只反复改写提示、工具、上下文与校验流程,让同一个冻结模型在任务上跑得更好。但这条路上一直有个隐痛——改出来的 harness 会「认模型」。
北京理工大学、清华大学等团队 10 月 20 日挂出的 MaD-RSI 换了个角度:既然每个模型会犯不同的错,那这些「不同的错」本身就是最好的教材。他们让 4 个异构模型在同一套 query 上跑,把彼此的分歧做成一张张量表,再拿这张表去指导一套共享 harness 的改写。结果是:一套 harness,换模型直接用,训练 token 在三个通用任务上比各练各的省 18%~56%。
Self-Improvement of Agent Harnesses | |
Agent-SafetyBench | |
DeepSeek-V3.2 · Qwen3.8-Flash Qwen3.8-27B(留出 Doubao-2.0、GLM-5.3-Flash) | |
目 录
| 01 | 02 |
| 03 | 04 |
| 05 | 06 |
| 07 | 08 |
01
RSI 优化的是什么,为什么它会认模型
先把「harness」这个词钉死。它指模型权重之外、包在模型外面那一整层工程结构:系统提示词怎么写、工具集给哪些、工具调用协议长什么样、上下文如何裁剪与压缩、失败后重试几次、什么时候插入自检与校验。同一句「用 Qwen 修这个 bug」,harness 写得糙还是写得细,成功率能差出十几个点。
RSI 的做法很像给这个外层做「无梯度调参」:跑一批任务、收集执行轨迹、让一个 LLM 去读失败原因、提出 harness 修改方案、再跑一轮验证,循环若干次。整个过程只动文本、不碰权重,所以便宜、可解释、随时回滚。
单模型 RSI 的死结
若整个搜索过程只看一个模型的执行反馈,harness 会过拟合到这个模型的怪癖上:它偏爱长思考,就把提示写成「先列 5 步」;它的工具调用爱漏参数,就加一层参数校验。换一个模型,这些补丁一半会失效,一半会反噬。论文把这种现象称为「harness 与目标模型的强耦合」,并指出它直接堵死了「可复用 harness 生态」这件事。
更麻烦的是,这套耦合还会自我强化:因为耦合,你不敢跨模型复用;因为不敢复用,每个新模型都要重跑一次完整 RSI;因为要重跑,成本随模型数量线性膨胀。而评价方式也在助长这件事——业界通行做法是「用一个模型练、事后测一测能不能迁移」,模型差异在这个流程里只是考卷,从来不是教材。
MaD-RSI 的出发点就一句话:既然差异是客观存在的,为什么只拿它当考卷?
02
范式翻转:模型即数据
左半边是旧范式:一组 query 喂给「模型 + harness」,产出轨迹,分析、改 harness、再循环。右侧是新范式:一组 query 同时喂给 4 个模型,在相同采样配置下各自产出轨迹,把「谁对谁错」摊成一张表,然后再去分析。
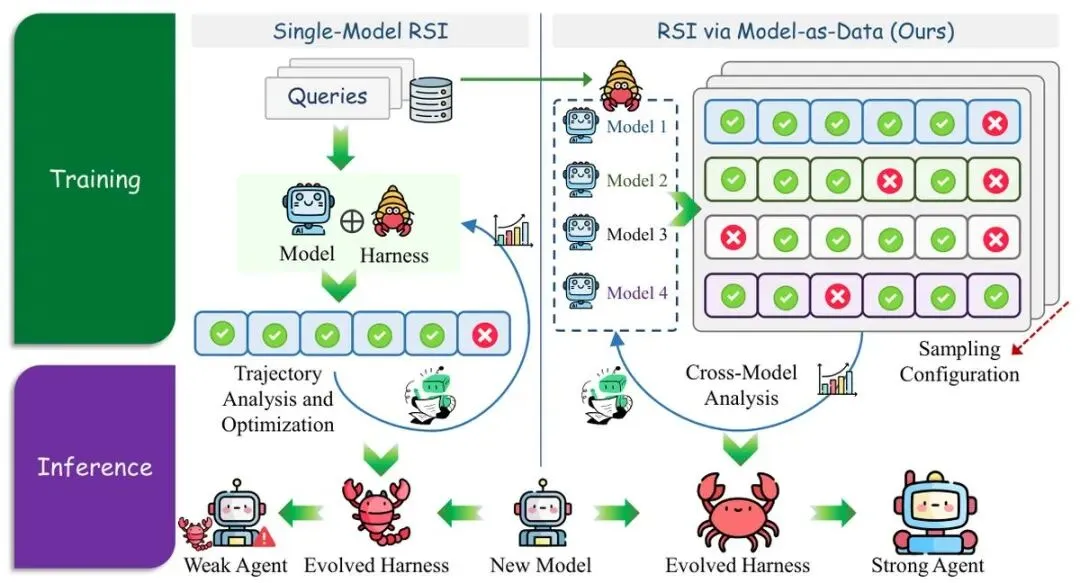
注意图里几个容易被忽略的细节。第一,右侧的四个模型各自有一行结果,勾叉交错——分歧是肉眼可见的;第二,右下角标着「Sampling Configuration」,说明同一个模型还会用不同温度采样多次,模型维度之外还叠了一层采样维度;第三,最右侧新模型(New Model)拿到的是同一个「Evolved Harness」,不需要重新训练。
这就是全部野心的所在:不是「让多个模型投票」,而是「用一个模型池的失败经验,训练一份所有模型都能穿的工装」。论文特意强调,目标绝不是推理时做模型集成,而是让同一个 harness 在任意单个模型上独立使用。
视角转换的准确表述
旧范式:模型 = 优化目标 + 事后评测对象。
新范式:模型 = 采集行为证据的数据源,共享 harness 才是唯一的优化中心。「Models-as-Data」与「Models-as-Targets」的区别,就是从「给谁做衣服」变成「按一群人的身材做版型」。
这里还有一个隐含前提值得点出:能被当数据的,是「受控条件下的行为分布」,不是模型本身。所以论文才要固定温度、固定重复次数、固定 query 集合——只有在条件对齐的前提下,「A 对 B 错」才能被解读为有意义的信号,而不是随机的运气差。
03
三步机制:对齐 · 挑样本 · 联合归因
第一步:把结果摊成三维张量
对每个 query q、每个模型 m、每种采样配置 s,记一个经验成功率 p。三维堆起来就是响应张量 P;固定 s 切开,得到一张 N×M 的矩阵——行是 query,列是模型。这张矩阵是整个方法的「原始数据」。
P[q, m, s] ∈ [0, 1]^(N × M × L)
  N query · M 模型 · L 采样配置
P[:,:,s] 是一页「谁在哪题翻车」的台账关键在于列的对齐:同一列是同一个模型在全部 query 上的行为画像,同一行是同一道题在全部模型上的表现。采样配置各自等权,模型权重 w 之和为 1(实验里 4 个模型各 1/4)。实验取温度 0.0 与 1.0 两种配置(L=2),每格各重复 2 次——所以每一个格子里装的不是一个数,而是一小撮同条件观测。
第二步:用「分歧」挑最值得看的 query
不是所有错题都有信息量。如果 4 个模型在某道题上全军覆没,那多半是题目或 harness 有结构性问题,改起来收益低;如果 4 个模型全对,也没啥可学。真正值钱的是有人对、有人错的那些题。论文用一个熵差来量化这件事:
D_q = (1/L) Σ_s [ h(p̄_qs)
    − Σ_m w_m·h(p_qms) ]
h(·) 为二值熵,p̄ 为加权平均成功率括号里是「整体熵减去个体熵的加权平均」——这正是集成学习里衡量委员会分歧的标准做法:如果各模型难易判断高度一致,两项相减接近于零;只有当大家在同一道题上判断分裂时,这个差值才会变大。用主动学习的语言说,MaD-RSI 把「模型间分歧」当成了查询函数(acquisition function)。
一个容易漏掉的设计:锚点题
纯按分歧挑样本会漏掉两类极端题——全对与全错。它们的 D_q 恒为零,但对「诊断」极有价值:全对题提供可对照的成功轨迹,全错题暴露共性缺陷。所以论文先预留一批「锚点 query」,再用「分歧 + 行为模式覆盖度」的联合增益填满剩余预算。覆盖度那一项防的是另一种退化:挑出 20 道几乎同质的题,分歧很大但信息重复。
还有一个细节:分歧要先在每种采样配置内部算完,再跨配置平均,不能把所有观测混在一起算。混池会抹掉「温度 0 稳定、温度 1 抖动」这类结构,而这恰恰是判断模型是否真的掌握某个能力的关键证据。
第三步:联合诊断,且必须引用证据
选好 query 之后,MaD-RSI 为每道题组装一个「证据包」:来自不同模型、不同采样的轨迹,保留各自的成败标签与来源 ID,装进一个输入预算内。然后做联合诊断——同时对比三类现象:
| 全失败 | 共性缺陷 | 优先改 |
| 单模型失败 | 模型怪癖 | 写成条件分支 |
| 成功轨迹 | 正面对照 | 防止改坏 |
论文里有一句话值得单独抄下来:「分歧本身既不能确立失败原因,也不能确立有效修法」。这就是为什么他们要求每一条诊断结论都必须引用证据 ID,再由一个 LLM 依据这些带引用的诊断去提 harness 修改方案。整个循环在通用任务上跑 3 轮,每轮留 2 个候选槽位——和动辄几十轮迭代的搜索式方法相比,这个轮数相当克制,因为它把算力花在了「看清证据」而不是「多试几次」上。
这套流程真正的瓶颈
不是搜索算力,而是归因。分歧只回答「该看哪道题」,不回答「为什么错、怎么改」。强制引用证据,本质是把「猜原因」这个最不可靠的环节,变成一件可以被检查、被驳回的工作。工程上这比多跑几轮 RSI 更值钱。
04
评价体系也换了:Pass@M 与一条不等式
传统 Pass@k 衡量「采样 k 次能不能对一次」;这里的 M 是模型个数,含义完全不同。论文给出两个互补的群体指标:
Pass@M = AVG_{i,r} max_m y_irm
Pass^M = AVG_{i,r} prod_m y_irm
  y_irm ∈ {0,1} 表示是否通过
i = query,r = 重复,m = 模型前者叫成功率覆盖(success coverage):只要有一个模型答对就算过,衡量这一池模型的天花板;后者叫联合成功率(joint success):四个模型全对才算过,衡量这一池模型的地板。
这两项指标的分工,恰好对应两种完全不同的工程需求。做能力探索、或者知道可以路由到最强模型时,你关心 Pass@M;但真在生产环境里做模型池、按成本分层调度时,你更在意「任何一个模型接手都不会掉链子」,那就是 Pass^M。
指标口径必须看清楚
论文的 Pass@M 是在对齐的 (query, 重复次数) 位置上取平均,不是在重复里取最优。原文特意说明:重复序号只用于对齐记录,不代表共享随机种子。这意味着它和传统 Pass@k 的数值不可直接比较,跨论文引用这些数字时要小心。
第二个新东西是成本判据。设 H_best 是所有独立优化里最好的那套 harness、综合得分 S_best,H_mad 是共享 harness、得分 S(H_mad);独立跑 M 次的总训练成本记 C_Σ,共享优化成本记 C_mad。在效用 S − λC 下,共享方案被弱偏好,当且仅当:
S_best − S(H_mad) ≤ λ · (C_Σ − C_mad)λ 是「每 token 值多少分」的换算率,必须在比较结果之前就固定下来。这条不等式写得相当讲究:它不要求共享 harness 打赢最好的单体,只要求「分数上的亏」能被「省下的算力」按事先约定的汇率找补回来。这比「我们提升了 X% 所以更好」诚实得多。
05
结果:涨的是地板,不是天花板
四模型主结果
先看覆盖面。四个数据集里,MaD-RSI 在 LawBench 上把 Pass@4 从 62.50 拉到 73.00,其余三个数据集——MBPP+ 93.00、MedXpertQA 60.00、SafetyBench-UA 94.55——与最强单模型基线完全持平。也就是说,覆盖率这边并没有「变强」,只是「没变弱」。
| 原始 harness | 62.50 | 93.00 | 60.00 |
| RRSI 最强单模型 | 61.50 | 93.00 | 60.00 |
| MaD-RSI(共享) | 73.00 | 93.00 | 60.00 |
再看联合成功率,情况完全不同:LawBench 42.50→48.00,MBPP+ 76.50→80.00,MedXpertQA 13.00→18.00。MedXpertQA 那一格的相对提升高达 38%,虽然绝对值仍然只有 18.00。
| 原始 harness | 42.50 | 76.50 | 13.00 |
| RRSI 最强单模型 | 43.50 | 78.50 | 13.00 |
| MaD-RSI(共享) | 48.00 | 80.00 | 18.00 |
「RRSI 最强单模型」指四个单模型基线在该列上的最大值,与图 2 里 Baseline (MAX) 同口径;这些最大值可能来自不同的 harness。
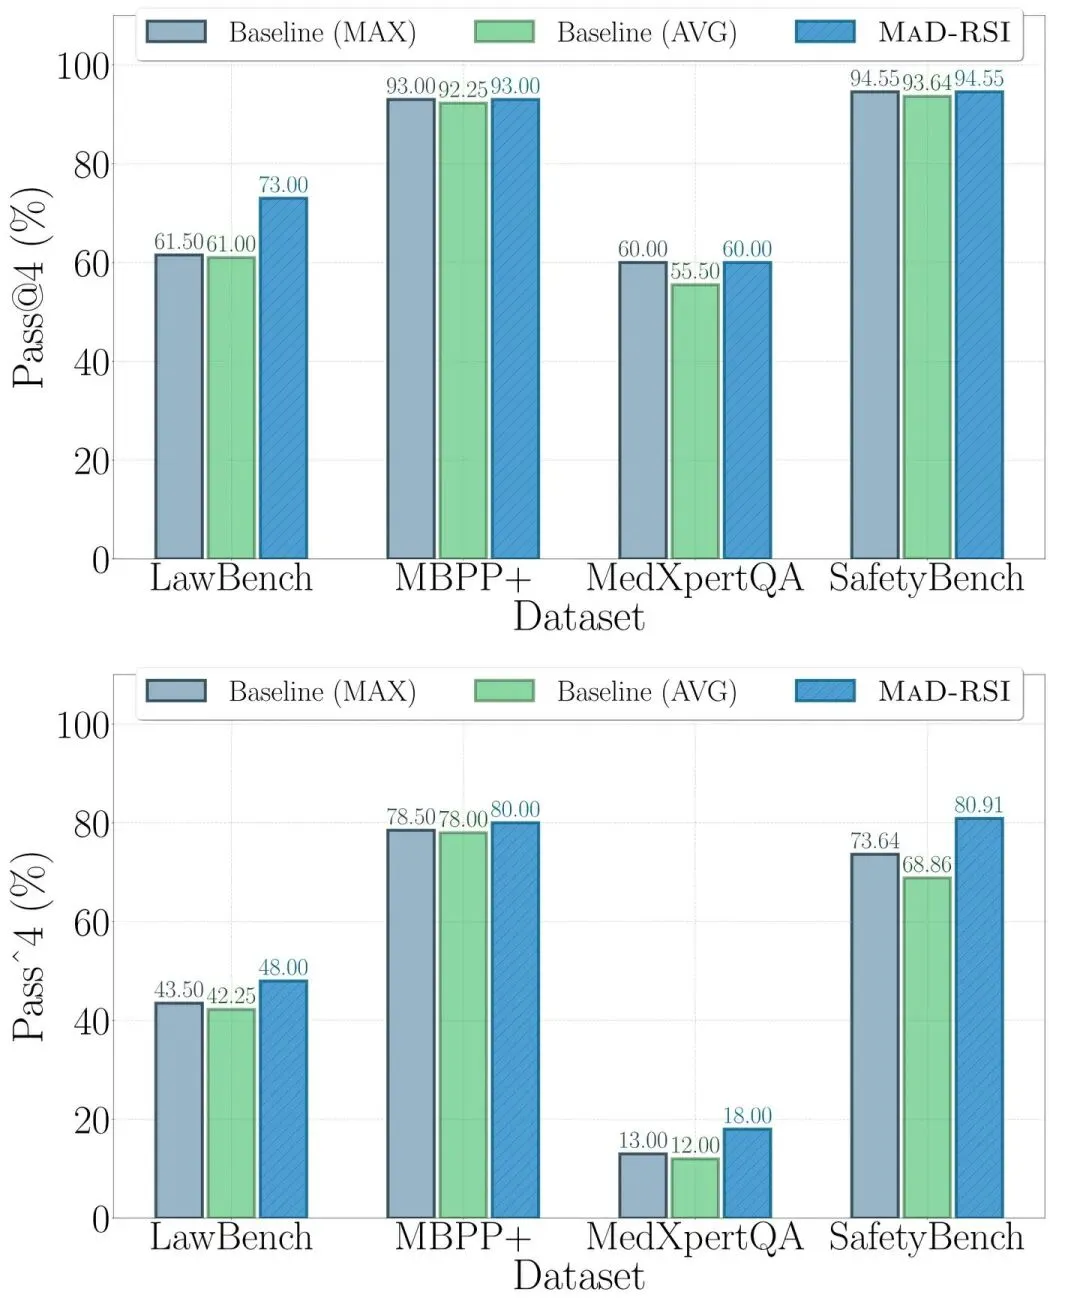
这个「上平下起」的形态不是巧合,它本身就是结论:共享 harness 并没有让模型池触到更高的天花板,它做的是把地板整体抬高。机制上也讲得通——用多模型失败证据去改 harness,凡是只对某一个模型怪癖有效的改动,都会在其它模型的失败轨迹里被否掉;能留下来的,是对所有模型都不掉链子的通用改法。
一个很好用的观察
MedXpertQA 的 Pass@4 是 60.00,Pass^4 只有 13.00。换句话说,超过八成的高难度医学题上,至少有一个模型翻车。专家级推理能力在模型之间是高度碎片化分布的,没有一个模型是「全面更强」,这也是为什么这套方法在这里收益最大。
安全任务:联合成功率涨得最狠
SafetyBench 上,攻击安全 AS、攻击下效用 UA、干净安全 CS 三个指标,MaD-RSI 的联合成功率分别是 98.93 / 80.91 / 86.25,全部超过最好的单模型基线。其中 UA 的 +7.27 个点最值得看,因为它的覆盖率 94.55 与基线完全相同——能力覆盖没变,一致性变了。
| 方案 | AS | UA | CS |
|---|---|---|---|
| 原始 harness | 96.79 | 66.36 | 75.00 |
| SHE 最强单模型 | 97.14 | 73.64 | 80.00 |
| MaD-RSI(共享) | 98.93 | 80.91 | 86.25 |
安全任务里 AS 的覆盖率在所有方案上都是满分 100.00,UA 的覆盖率也全部是 94.55,这说明「挡住攻击」这件事的难度已经不在可达性上,而在稳定性上。同一套 harness 面对不同模型的行为差异时能不能稳住,才是真正的分水岭。
换两个没见过的模型:六模型验证
真正检验泛化的是留出集。论文把 Doubao-Seed-2.0-Mini 与 GLM-5.3-Flash 加进池子,变成六模型评测,Pass^6 在全部 6 个数据集-指标组合上优于预选基线。
| LawBench | 36.00 | 38.50 | +2.50 |
| MBPP+ | 74.50 | 77.50 | +3.00 |
| MedXpertQA | 8.50 | 13.00 | +4.50 |
| Safety-AS | 94.64 | 97.50 | +2.86 |
| Safety-UA | 66.36 | 76.36 | +10.00 |
| Safety-CS | 70.00 | 76.25 | +6.25 |
表中 LawBench 与 MedXpertQA 为准确率,MBPP+ 为通过率,Safety 三项分别为攻击安全、攻击下效用、干净安全。
两个细节必须一起读。第一,绝对值的下滑是指标本身的性质:从 4 个模型要求同时成功,变成 6 个模型同时成功,Pass^M 必然随 M 单调下降(LawBench 48.00→38.50、MedXpertQA 18.00→13.00)。所以这套指标的绝对值只能在同一 M 下比较,千万别跨 M 引用。
第二,UA 的覆盖率出现了轻微倒退:Pass@6 从基线的 96.36 掉到 95.45,而联合成功率同时从 66.36 升到 76.36。这是一个典型的「一致性换可达性」的权衡——为了所有模型都稳住,个别原本能被某个模型蒙对的样本被牺牲了。论文的表述是「在部分设定下提升、权衡因任务而异」,这句限定词用得很实在。
06
算力账:省在「不重复造轮子」
成本对比的对象是「四个单模型基线各自跑完 RSI 的总和」,也就是 C_Σ。训练 token 上,MaD-RSI 在 LawBench 省 18.3%、MBPP+ 省 55.9%、MedXpertQA 省 52.4%,但在安全任务上多花了 15.2%。
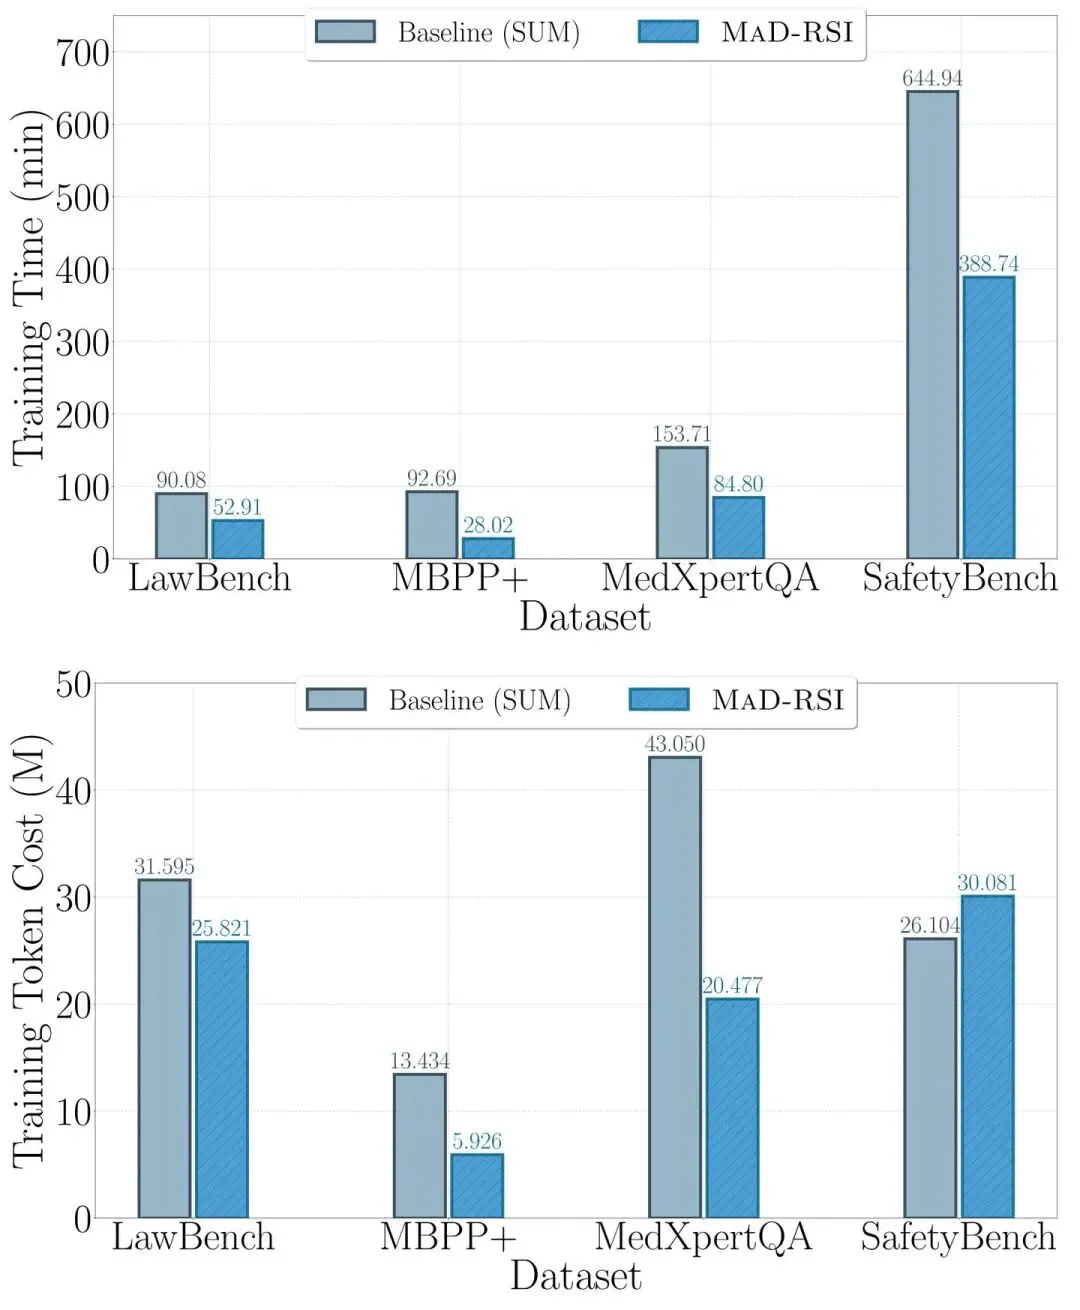
安全任务为什么反而更贵,论文没展开,但机制上不难推:安全 harness 通常要引入更复杂的校验链与拒答判据,多个模型的失败证据互相拉扯时,要收敛到一套同时满足「挡住攻击」与「不误伤正常请求」的写法,需要更多轮修改与验证。这是「一致性的代价」,而不是效率问题。
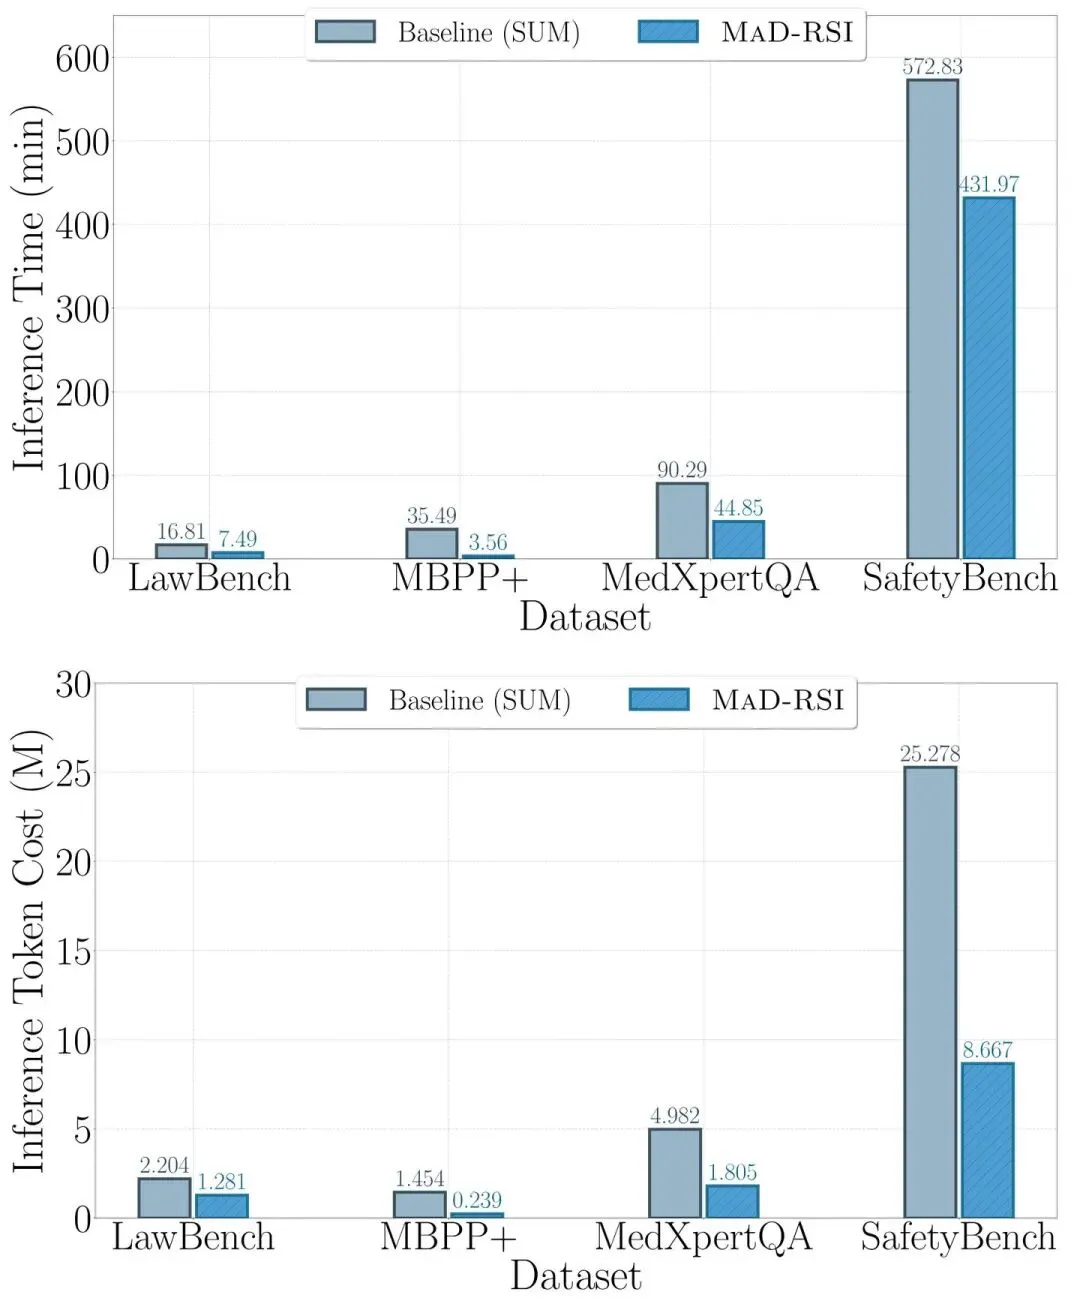
| 数据集 | 训练 token | 训练时长 | 推理 token |
|---|---|---|---|
| LawBench | −18.3% | −41.3% | −41.9% |
| MBPP+ | −55.9% | −69.8% | −83.6% |
| MedXpertQA | −52.4% | −44.8% | −63.8% |
| Safety | +15.2% | −39.7% | −65.7% |
推理时长的降幅同样全线为负:LawBench −55.4%、MBPP+ −90.0%、MedXpertQA −50.3%、SafetyBench −24.6%。
把这四行放在一起,收益结构就很清楚了:训练侧省的是「重复劳动」——M 个模型不再是 M 次完整搜索,而是共享主干;推理侧省的是「回合浪费」——harness 更会收敛,同样的任务用更少的 token 与更短的时间走完。推理侧的节省尤其重要,因为它是长期、随调用量线性放大的那一块。
07
我的判断:四个洞察与四个问号
四个洞察
洞察一:把「差异」从评价指标升级为采集策略。这是全文最锋利的一刀。跨模型差距在旧范式里是训练结束后的成绩单,MaD-RSI 把它提到了训练过程内部,变成决定「看哪些样本」的依据。这个动作在机器学习史上有明确的亲缘关系——主动学习的委员会查询、集成蒸馏、多任务数据筛选,都是同一个思路的不同外壳。所以与其说它是全新的方法,不如说它把一个成熟的思想第一次系统性地搬到了 harness 上。
洞察二:这套方法买的是方差,不是上界。覆盖率齐平、联合成功率上行,意味着它压缩的是模型之间的行为方差。工程含义很直接:如果你的部署形态是「模型池 + 按成本/延迟路由」,那这套东西正好补齐最痛的那块——低配模型接手时不会突然崩;如果你只是固定用最强那个模型,收益会小得多。
洞察三:真正的稀缺资源是归因能力,不是搜索次数。整个流程里最贵的环节是「联合诊断 + 证据引用」,而不是跑模型。这解释了一个常被忽略的事实:多数 RSI 的失败不是搜索空间不够大,而是改错了地方——把耦合在某个模型上的怪癖当成了普适缺陷。
洞察四:总成本随模型数摊薄,这是它的经济学根基。独立 RSI 的成本是 M×C,共享优化的成本接近 1×C 加一点对齐开销。M 越大,优势越明显;而现实中模型池只会越来越大。这条曲线决定了它的长期价值,比任何单点涨分都更重要。
四个问号
问号一:「更省」有一个容易被误读的前提
λ 判据里的对照组是「四个独立跑里取最好」,成本记 C_Σ(四次全付)。如果你事先就知道要部署哪个模型,你只需要付 C_min。共享 harness 的成本优势,本质上是在为「事先不知道谁最好」这件事付保险金。论文在设定里明确写了这个前提,但读者很容易把它读成「普遍更省」。
问号二:模型池的异质性可能被高估
四个执行器是 DeepSeek-V4-Flash、DeepSeek-V3.2、Qwen3.8-Flash、Qwen3.8-27B,同代、同语料风格、行为高度重叠。而「Model-as-Data」的收益应当随异质性增长。论文没有给出「异质性程度 → 收益大小」的消融,所以「多模型证据」到底需要多不同,目前还是个开放问题。
问号三:关键超参没有敏感性分析
分歧项与覆盖项如何配比、锚点 query 占多大比例、诊断的证据预算给多少、λ 取多少——正文都没有扫。加上作者自陈「preliminary evidence / still in progress」,这些数字更应读作方向性证据,而不是可直接复现的配方。
问号四:harness 本身没有被打开看
论文报告了「改了之后更好」,但没有展示具体改了哪些条目、哪些改动是跨模型通用的、哪些是条件分支。对做工程的人来说,这部分恰恰是最想抄的。这也是短论文的通病:结论可信,但可迁移的知识密度不足。
把四个洞察与四个问号放在一起,我的整体判断是:这是一篇「视角价值大于数字价值」的论文。它的实验规模不大、留白很多,但「模型即数据」这个提法一旦成立,后续能长出来的东西(多模型 harness 市场、跨模型评测协议、按模型族分层采集证据)比它现在报的这几个点重要得多。
08
结语:harness 从「定制品」变成「公共资产」
过去两年,harness 更像一件「定制品」:为一个模型、一个任务、一个团队手写,换模型就得重做。MaD-RSI 想把它变成「公共资产」——像一份被多个 CI runner 共同验证过的代码库,谁都能拿去用,谁的新失败都会变成下一次改进的输入。
这条路要真正走通,还差三块拼图:一是证据的标准化,让不同来源的轨迹可以被对齐、被引用、被审计;二是异质性的度量,搞清楚什么样的模型组合才值得放进池子;三是可读的 harness,让「改了哪一条、为什么改」变成人能审的文本,而不是一团黑箱提示词。
一句话总结
MaD-RSI 真正的主张不是「用多个模型训练一个 harness」,而是「把模型之间的差异当成一种可以被开采的资源」。前者是一个方法,后者是一个可以持续十年的问题设定。
对正在做 Agent 落地的团队,这篇论文给了一个很实际的提示:当你的模型池里同时跑着贵模型和便宜模型时,与其为每个模型单独调 harness,不如先把「同一批任务、多种采样、多模型」的轨迹对齐存下来。哪怕暂时不做 RSI,这份台账本身就是最值钱的资产——它记录的不是模型有多强,而是模型在哪里不一样。

