人工智能全景教材:「智能体」作为能从感知序列映射到动作的东西,怎么在信息不完备的世界里做出合理选择
- 2026-11-23 06:33:45
罗素和诺维格这本教材里最核心的一句话是:A rational agent is one that does the right thing——理性智能体,就是做正确的事的智能体。后面二十多章从搜索、逻辑、概率一路写到学习、视觉、机器人,都在给这句话补注释。
更重要是,这两位著名的人工智能学家提出:我们真正该造的,不是死死追着自己目标跑的机器,而是追着人的目标跑、并且知道自己并不确定人的目标是什么的机器。
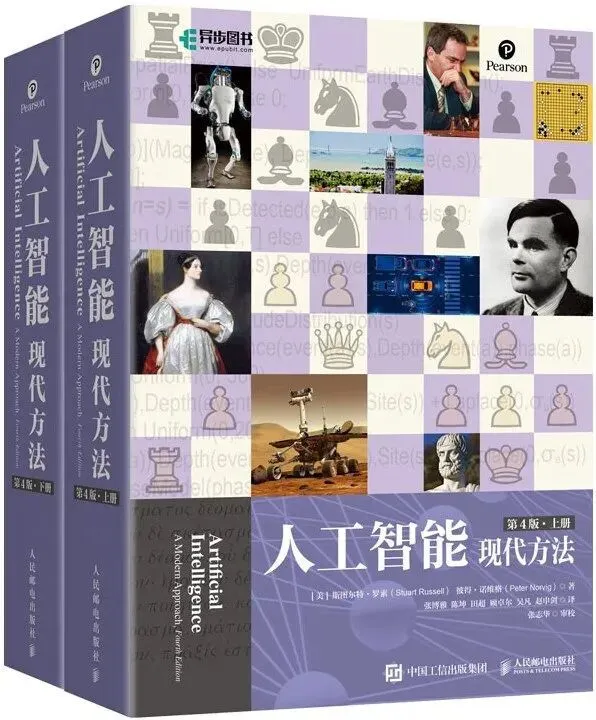
《Artificial Intelligence: A Modern Approach, 4th US ed》.,Stuart Russell 与 Peter Norvig 著,Pearson 2020 年 4 月 28 日出版,中文版《人工智能:一种现代方法》,由人民邮电出版社出版。这是人工智能领域通行的一本系统性教材,全球有1500多所大学采用这本书为人工智能教材。把「智能体」作为贯穿全书的主线:一个能从感知序列映射到动作的东西,怎么在信息不完备的世界里做出合理选择。
全书分七部分、二十八章:从搜索与问题求解,到逻辑、知识表示与规划,再到概率推理、机器学习、自然语言、视觉与机器人,最后落到智能体的哲学、伦理与安全。它押的是骨架,不是某个一时最强的模型——第 2.3 节那张任务环境属性表,仍是判断「一个任务难在哪」最好用的一把尺子。
一、全书先摆四条路:像人一样思考、像人一样行动、理性地思考、理性地行动。作者选第四条,并且选得很坚决——书名里的「现代方法」,指的就是不靠模仿人、靠把「做正确的事」形式化。第 1 章那张二乘二的表,是后面二十七章的总开关。
二、「理性」不是聪明,是一条能算的定义:对每个可能的感知序列,理性智能体应当依据已有证据与内置知识,选择期望性能度量最大的那个动作。它不要求全知,只要求在信息不完备时把期望算对;也不要求永远成功,只要求按当时掌握的信息做了最优选择。第 2 章用四样东西把「当时」钉死:性能度量、先验知识、可执行动作、到此为止的感知序列。
三、性能度量是人给的——书里特意区分「理性」与「全知」:理性最大化期望性能,全知才最大化实际性能。可一旦追问「这张表谁填的、填得对不对」,第 2 章就不回答了。作者给的自动驾驶反例很干脆:若把「绝对安全」当硬目标,最优解是把车留在车库里不动。目标写错,算得越准,跑得越偏。
四、不确定性不是补丁,是后半本书的主体。从第 12 章起讲概率、贝叶斯网、时序推理、概率编程,中间几章讲简单决策、复杂决策与多智能体决策。为什么要花这么多篇幅?因为现实环境大多是部分可观测、随机、动态、连续的。书里的立场很硬:理性要最大化的是期望性能,不是「听起来确定」。
五、学习是补齐先验知识的不足,机器人是这套框架落到物理世界的考场。学习那几章从示例学习、概率模型、深度学习到强化学习;语言、视觉与机器人几章则是把决策接回现实。前者问「从有限示例中怎么推出可泛化的规则」,后者问「感知到的东西怎么变成动作」,两者其实是同一个问题的两端:内置知识不够用的时候,机器靠什么补。
六、最反直觉的是作者亲手拆台。第 1.1.5 节说,标准模型假定我们能把目标完整写进机器,而一旦走进真实世界,这件事几乎做不到;他们把「我们真正的偏好」与「塞进机器的目标」之间的落差命名为价值对齐问题,并给出方向:不让机器笃信一个固定目标,而是让它知道自己不确定人的目标,于是有理由谨慎行事、请求许可、观察人类选择、服从人的控制。作者还坦白,本版绝大多数技术内容仍是在标准模型里写成的。
七、把这些连起来,这本书的张力就不在「AI 有多强」,而在两个始终没被合上的问题:目标从哪来,以及不确定性怎么留在系统里。第 2 章把第一个问题关进性能度量表里,第 1.1.5 节又把它放出来;概率与决策那几章把第二个问题写成了整套数学,第 27 章再补一句「人的偏好未必一致、也很难反演」。读这本教材,最值得带走的不是某一种算法,是这两处没有盖上的盖子。
Q1. 「做正确的事」——这个「正确」,到底由谁写进机器?
第 2 章给了一个看起来很干净的答案:由性能度量定义,用 PEAS(性能、环境、执行器、传感器)把任务环境描述清楚,智能体照着最大化就行。但性能度量是设计者从外面放进去的,不是智能体自己长出来的;书里特意区分「理性」与「全知」,也等于承认:理性只对给定目标负责,不对目标本身负责。作者没有把这件事糊过去。第 1 章末尾的自动驾驶反例写得很直白:把「绝对安全」设成硬目标,最优解就是永不发车。目标一旦写死,机器越能干,越会把人没写进去的那部分愿望优化掉。所以第 1.1.5 节的诚实之处,不在于给出了新答案,而在于承认「写不全」,并把这份承认变成新的设计起点:机器应当知道自己并不知道完整目标,因而愿意谨慎、发问、观察与让出控制权。全书最锋利的一段,就是第 2 章与第 1.1.5 节之间这不到四十页的距离。
Q2. 一本用标准模型写成的书,为什么开头就说标准模型不对?
这是全书最值得慢慢读的一处张力。第 1.1.5 节说,标准模型假定我们给机器一个完整指定的目标;对下棋、最短路这种自带目标的人造任务,它成立;可一进真实世界,目标就写不完整——书里举了自动驾驶,也在第 27 章用点金术这类思想实验说明「完全照办目标」与「人真正想要」之间的落差。于是作者写了那句几乎推翻自己的话:我们不想要那种「追着自己目标跑」的智能机器,我们想要的是追着我们的目标跑的机器。他们甚至坦白,本版绝大多数技术内容仍是在标准模型里写成的,只是关机问题、辅助博弈、逆强化学习、偏好不确定性,已经是在给新框架打样。把这个顺序读明白,后面那些章节就有了两层意思:它们既是标准模型里最完整的一套技术图谱,也是作者留给后来者的一份「这里还没解决」的清单。教科书敢在开头标注自己的前提不成立,比多写十章算法更难得。
Q3. 一本覆盖二十八章的教材,为什么读不到「哪种模型最强」?
因为它押的不是模型,是骨架。深度学习、自然语言处理这些方法,书里都有,但写的是可形式化的结构:函数、损失、梯度、概率图、马尔可夫决策过程。具体哪个模型在某个时点最强,本来就不该由教材回答,那是会被下一版冲掉的信息。骨架长什么样?智能体仍是「感知序列 → 动作」的智能体函数,规划仍是状态空间里的搜索,不确定仍是概率,决策仍是期望效用,对齐仍是目标从哪来。第 2.3 节那张环境属性表(可观测性、单/多智能体、确定性、片段/连续、静态/动态、离散/连续、已知/未知)仍是最好用的一把尺子,因为它不依赖任何一个具体模型。读法也要跟着换:别把它当产品手册,把它当量具。遇到任何一个新系统,先问它把哪一段做对了、哪一段悄悄跳过了——尤其是「性能度量从哪来」和「不确定性有没有被留在输出里」这两格。
BQ1. 方向一:从「把理性写成定义」到「承认目标写不全」,第 2 章与第 1.1.5 节之间那段路
第 2 章把智能体写成一句数学描述:把任意感知序列映射到一个动作;智能体程序才是它在物理系统里的实现。作者特意提醒别把两者混为一谈。这一步走得很漂亮:只要性能度量、先验知识、可执行动作、感知序列四样东西给定,「理性」就能被定义、被比较、被写进公式。难点从下一页开始。性能度量表是外部填入的;环境一旦从「片段式、静态、完全可观测」变成「连续、动态、部分可观测」,表里就得写进时间、风险与别人的反应,而人往往说不清自己要什么。第 1.1.5 节把这件事命名为价值对齐问题,并给出三条新框架:机器以最大化人类偏好为唯一目标、机器起初并不确定这些偏好是什么、关于人类偏好的最终信息来源是人类行为。书里随后几章是在给这三条打样:关机问题证明机器有理由允许自己被关掉,当且仅当它对人类目标不确定;辅助博弈处理人机之间的目标交错;逆强化学习从人类选择里反推偏好;第 27 章再补两道难题——人的偏好经过复杂认知结构才变成选择,很难反演,而且人自己的偏好未必一致。所以这条方向不是「从旧理论到新理论」,而是同一本书里两套框架并存:前面教你怎么把目标算到极致,末尾与开头反复提醒你,目标本身还没着落。读书时把这两层分开,才不会把形式化的漂亮误当成问题的解决。
BQ2. 方向二:从「把不确定性建模」到「把价值判断摆上台面」,概率那几章怎么接到第 27 章
概率、贝叶斯网、时序推理、概率编程,再到效用、期望与多智能体决策,这一整块处理的是「信息不完备时怎么做」。这条线的技术立场很明确——不确定性不是要被消除的噪声,而是决策必须带着走的输入;理性最大化的是期望性能,不是听上去更确定的那个答案。第 27 章把同一个问题换了个问法:如果连「什么算好」都不确定,该由谁来决定?书里关于公平的表述很克制也很锋利——公平有很多种,不可能同时把它们都最大化,所以第一步是先决定这里到底什么叫公平。透明、可解释、可问责随之而来,它们不是算法指标,而是把价值判断摆到台面上的程序。把这两段对读,会得到一个不太舒服但很清楚的结论:前半本书教你把不确定性算清楚,最后一章告诉你还有一类不确定性算不出来,只能被讨论、被选择、被交代。前者靠数学,后者靠制度与人的判断,中间隔着很长一段路,谁也不该替代谁。也别误会安全与伦理放在最后是疏忽——教科书按知识依赖排序,得先讲完智能体怎么决策,才谈得上决策该服从谁。但读者完全可以倒着读:先翻第 1.1.5 节,再跳第 27 章,回头看中间那些章,会省很多力气。
要点 1第 1—2 章:四条路,选一条,然后把它写成公式
第 1 章把学科拆成二乘二:像人一样思考/行动,理性地思考/行动;作者押「理性地行动」,理由是它数学上精确、不必先搞清楚人脑、且能自然处理不确定性。第 2 章给出智能体、感知序列、智能体函数、性能度量、理性、自主性,并用 PEAS 描述任务环境。第 2.3 节那张环境属性表值得单独抄下来:可观测性、单/多智能体、确定性、片段/连续、静态/动态、离散/连续、已知/未知。它把「这个任务难在哪」变成了可以逐格打勾的清单,是全书最实用的一页。
辨析:这套框架强在可计算,弱在「性能度量从哪来」它没有回答——全书最锋利的裂缝就在第 2 章与第 1.1.5 节之间。读时别把「理性」误读成「正确」,它只是「相对给定目标的最优」。
要点 2搜索、逻辑与规划:把「想清楚再动」变成算法
从盲目搜索、启发式、对抗搜索、约束满足,到逻辑智能体、一阶逻辑、知识表示与自动规划,这一整块处理的是「环境模型已知、目标清楚」时怎么找动作序列。搜索那几章把问题抽象成状态、动作、转移模型与目标检验,规划那几章再让机器自己排出一串动作。书里反复强调两件事:解的好坏取决于代价函数怎么定,搜索的规模取决于状态怎么表示。前者又绕回性能度量,后者是工程上最容易被低估的一步。
辨析:搜索与规划在目标可量化、状态可枚举时极强,一旦环境部分可观测或目标含糊,就会优雅地优化错的东西。别把这类人造任务上的成功外推到开放域任务——作者自己也没外推。
要点 3概率与决策:不确定性不是缺陷,是被建模的对象
概率、贝叶斯网、时序推理、概率编程、简单与复杂决策、多智能体决策,这一整块都在处理「信息不完备时怎么做」;效用与期望被请进来,博弈与机制设计也进来了。核心动作只有一个:不把信念压成一个确定答案,而是保留分布,再在分布上算期望。关机问题尤其值得慢读:当机器对自己的人类目标并不确定时,它就有理由允许自己被关掉。这是把「知道自己不知道」写进了决策结构,而不是写进一句口号。
辨析:把不确定性从系统里抹掉,看起来更可信,实际让使用者失去了校准判断的依据。书里的立场很硬——理性最大化的是期望性能,不是「听起来确定」。
要点 4学习、语言、视觉、机器人:以及「泛化」这道没跨过去的坎
从示例中学习、概率模型、深度学习、强化学习,再到自然语言、视觉与机器人。学习负责补先验知识的不足,感知与执行负责把决策落到物理世界。学习那几章问「从有限示例怎么推出可泛化的规则」,机器人那章问「感知到的东西怎么变成动作」;中间夹着奖励与试错。把它们连起来看,这一整块其实都在回答第 2 章留下的那个空白:内置知识不够用时,机器靠什么补。
辨析:书上把泛化写成一个学习理论问题,落到物理世界里却还要叠加传感器噪声、执行误差与陌生物体。读懂章节标题容易,读懂「为什么在训练环境里满分、换个房间就失灵」需要把第 2.3 节的环境属性表一起翻回来。
要点 5安全、伦理与未来:一本教材把自己交给了读者
第 27 章从「机器能思考吗」讲到公平、透明、可解释与 AI 安全,第 28 章讲未来。最重要的结构变化,是把对齐问题提到了第 1 章正文里——开头提出问题,末尾展开问题,中间那些章给出在旧框架里能做到的最好答案。第 27 章关于公平的表述值得记住:公平有很多种,不可能同时把它们都最大化;所以第一步是先决定,这里到底什么叫公平。它把「优化」之前那一步的价值判断明明白白地摆了出来。
辨析:安全与伦理放在最后不是疏忽,而是教科书按知识依赖排序的结果——但读者完全可以倒着读。先读第 1.1.5 节,再跳第 27 章,最后回头看中间那些算法,会更容易看出哪一章在解决什么问题、哪一章其实把问题暂时收起来了。
「A rational agent is one that does the right thing.」——第 2.2 节开篇。意译:所谓理性智能体,就是做正确的事的那一个。全书都在这里给这六个英文单词写注释。
「For each possible percept sequence, a rational agent should select an action that is expected to maximize its performance measure, given the evidence provided by the percept sequence and whatever built-in knowledge the agent has.」——第 2.2.2 节对理性智能体的完整定义。意译:对任一可能的感知序列,理性智能体都该依据已有证据与内置知识,选那个期望性能最大的动作。注意「期望」二字:它不保证结果最好,只保证在当时信息下最讲道理。
「We don't want machines that are intelligent in the sense of pursuing their objectives; we want them to pursue our objectives.」——第 1.1.5 节。意译:我们不想要那种只会追着自己目标跑的聪明机器,我们要的是追着我们的目标跑的机器。这句话把前面所有章节的标准模型推到了被审视的位置。
「When a machine knows that it doesn't know the complete objective, it has an incentive to act cautiously, to ask permission, to learn more about our preferences through observation, and to defer to human control.」——第 1.1.5 节。意译:当机器知道自己并不知道完整目标,它就有理由谨慎一点、开口问一句、从观察里学人的偏好,并把最终控制权交还给人。书里所有「让机器谨慎、请求许可、服从人的控制」的说法,几乎都能翻回这一句。
「There are multiple aspects of fairness, and it is impossible to maximize all of them at once. So a first step is to decide what counts as fair.」——第 27 章关于公平的表述。意译:公平有很多种,不可能同时把它们都最大化;所以第一步是先决定,这里到底什么叫公平。这句提醒:伦理讨论一旦落到系统里,先要做的不是调参,是把价值判断摆到台面上。
先读第 1 章的四条路径与第 1.1.5 节「Beneficial machines」,再读第 2 章的理性智能体定义。顺序别反过来:先看到作者亲手拆自己的台,后面那些章才读得出张力。
把第 2.3 节任务环境的七组属性抄在一张纸上,挑一个你熟悉的任务填 PEAS 表。逐个问:这个场景里,性能度量是什么?环境是部分可观测还是完全可观测?答不上来的那一格,往往就是这套框架最吃力的地方。
搜索与规划那几章按需要挑读。若关心「先想清楚再动」怎么做成算法,读搜索与自动规划两章就够;纯理论读者再回去补逻辑与知识表示。
概率与决策那几章慢读,这是最容易被跳过的骨架。边读边记一句:理性最大化的是期望性能,不是「听起来确定」。关机问题值得单独停下来,它是全书把「知道自己不知道」写成决策结构的地方。
学习、语言与机器人那几章按身份选:做学习方法的读示例学习与强化学习,做语言与多模态的读深度学习与自然语言处理,关心物理落地的直接翻机器人那章。读的时候把第 2.3 节那张环境属性表放在旁边,看哪些假设被悄悄放宽了。
最后一定读第 27 章与第 28 章,再回头重读第 1.1.5 节。若只想用一条最短路径抓住这本书的主张,这个「首尾闭环」比中间任何一章都值钱。
· 作者官网 AIMA 项目页(aima.cs.berkeley.edu)——可查看全书章目、配套课件与练习,顺着正文提到的每一章回到原书。
· 第 2 章 Intelligent Agents 公开教学复刻文本(artificialintelligence.readthedocs.io)——适合逐句对照「智能体函数/理性/PEAS/环境属性」的表述。
· 第 1.1.5 节 Beneficial machines 公开书摘——价值对齐问题、自动驾驶留在车库、以及「标准模型不够用」的完整论证都在这里。
· 想顺着对齐问题往下读:关于关机问题、逆强化学习与偏好不确定性的原始论文,多数可在作者主页与课程资料里找到线索。
© 2026 AI与心智探知

