MIT机器人操作 知识点笔记(8):让机器人从示范中学会操作——行为克隆(上)
- 2026-11-17 23:31:27
从第八讲开始,连续多讲的课程都把视角放到了目前最热门的深度学习上。本讲先从最简单的假设开始:如果人已经把任务做了几十到几百次,机器人能否直接学会从观察到动作的映射?〔1〕
行为克隆(Behavior Cloning,BC)就是用专家的动作作为监督标签来训练机器人,目前在很多Demo场景都取得了不错的演示效果。但由于机器人需要连续地与物理环境交互并施加影响,实际难度比纯静态的监督学习更高。
课程开篇首先展示了两家位于全球第一梯队的通用机器人基础模型公司的代表模型:Physical Intelligence 的π₀.₇和 Generalist AI 的GEN-1.5。
π₀.₇:由美国 Physical Intelligence(简称 PI)开发,2026年4月发布。它在第一梯队中,是通用灵巧操作和跨任务泛化能力的重要代表。
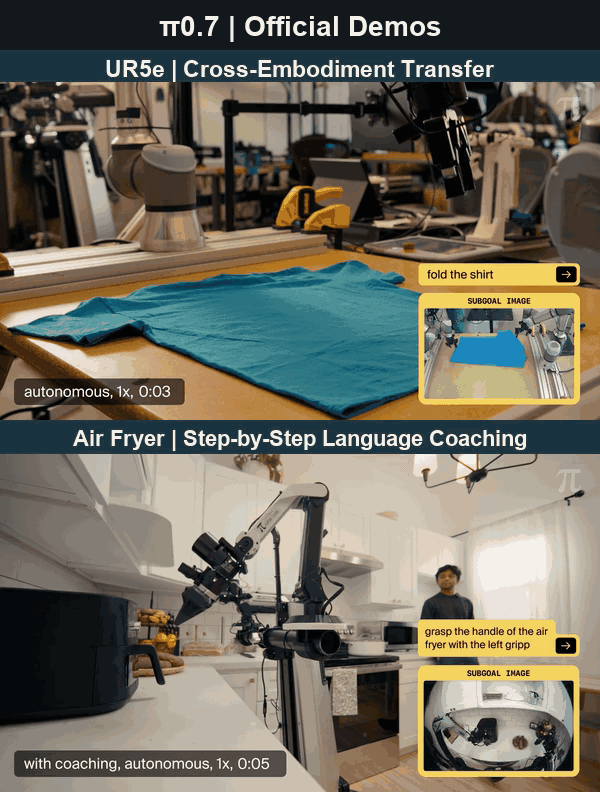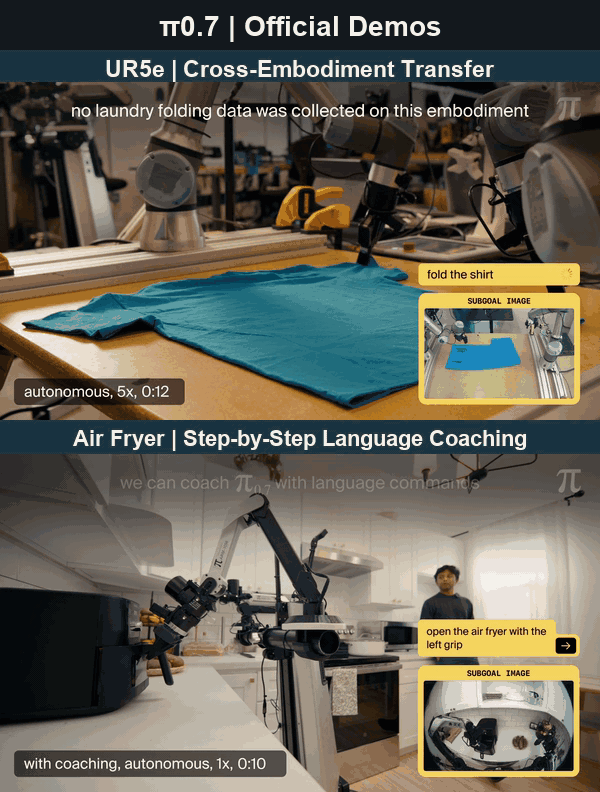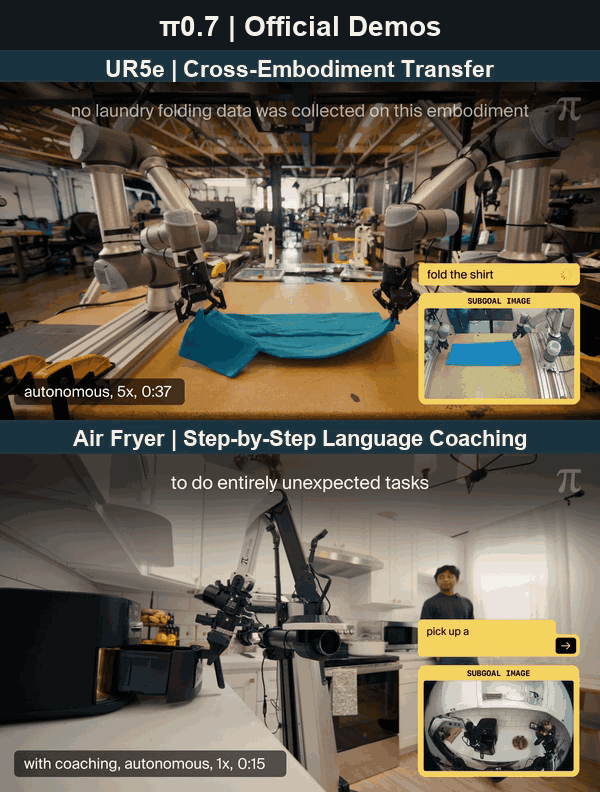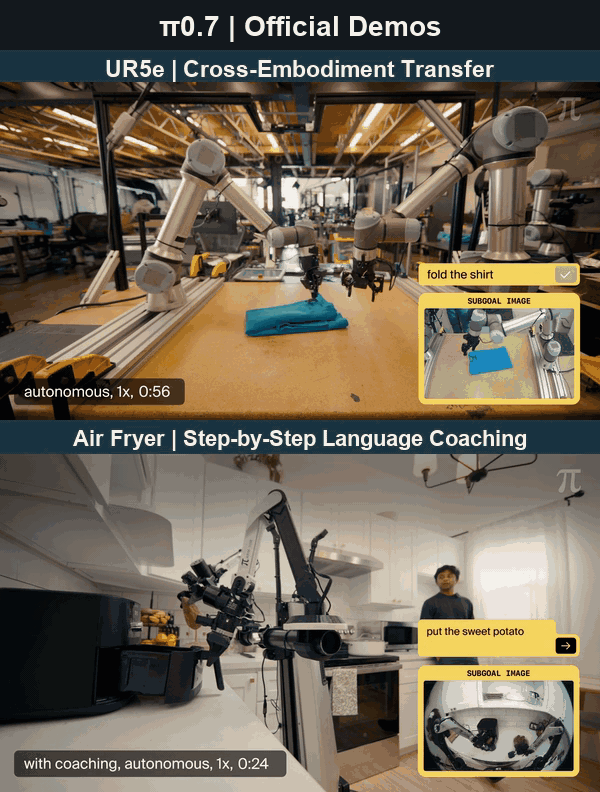 动图1 π₀.₇展示了复杂操作和泛化能力:可以将能力跨机器人迁移;也可以通过语言指导将技能组合起来完成新任务。〔2〕
GEN-1.5:由美国 Generalist AI 开发,2026年8月发布。它在第一梯队中,是物理One-shot Learning方向的重要代表。GEN-1.5的单样本上下文学习,就像是GPT-3 所展示的那种预训练模型泛化能力。
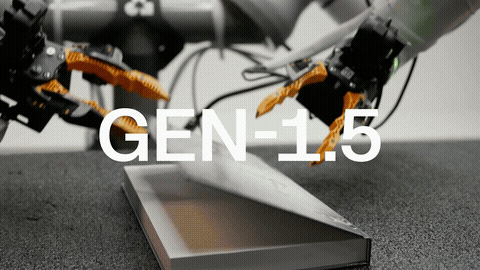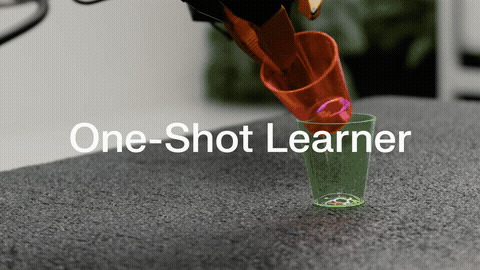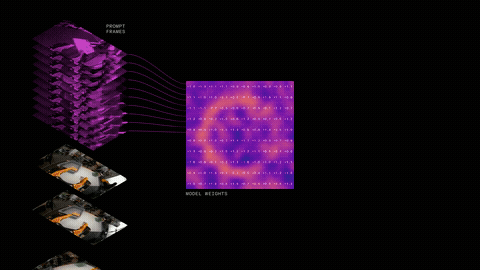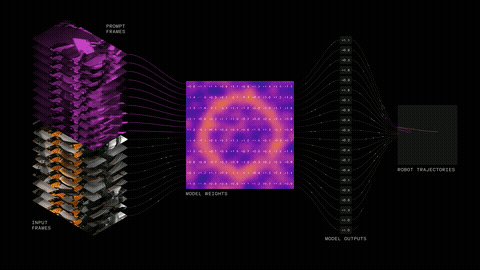 动图2 GEN-1.5展示了单样本与少样本上下文学习能力:通过一次或少数几次示范,快速学会此前没有专门训练过的操作任务。〔3〕
如果我们想教机器人抓起桌上的杯子,最直接的方法就是先让人类通过遥操作设备,带着机器人反复完成这项任务。
在示范过程中,同时记录两类信息:
这样,每一个时刻都会形成一组“观测—动作” 数据。把多次示范中收集的这些数据汇总起来,就可以得到专家示范数据集:
其中, 表示机器人当时观察到的信息, 表示人类专家在该情况下执行的动作。
例如,当杯子位于机械臂左前方时,模型应该预测出机械臂将向左前方移动;当夹爪已经对准杯子时,模型应该预测出下一步夹爪将闭合。
训练好的模型称为策略(Policy),用 表示。它描述的是:在给定观测信息 的情况下,模型应该如何选择动作 。
训练的数学目标可以写成:
它表示通过不断调整神经网络的参数,让模型越来越倾向于预测出专家实际执行的后续动作。
这与大语言模型预测下一个Token的思路有相似之处,因此课件中用 next-token prediction 来帮助理解BC。
不过,需要注意的是,机器人行为克隆比AI与人类进行对话聊天的挑战大得多:错误的预测会直接改变现实世界,而模型可能很少见过偏离后的场景,后续动作就更容易出错,导致误差不断增大;而人机对话显然没有这方面的问题。
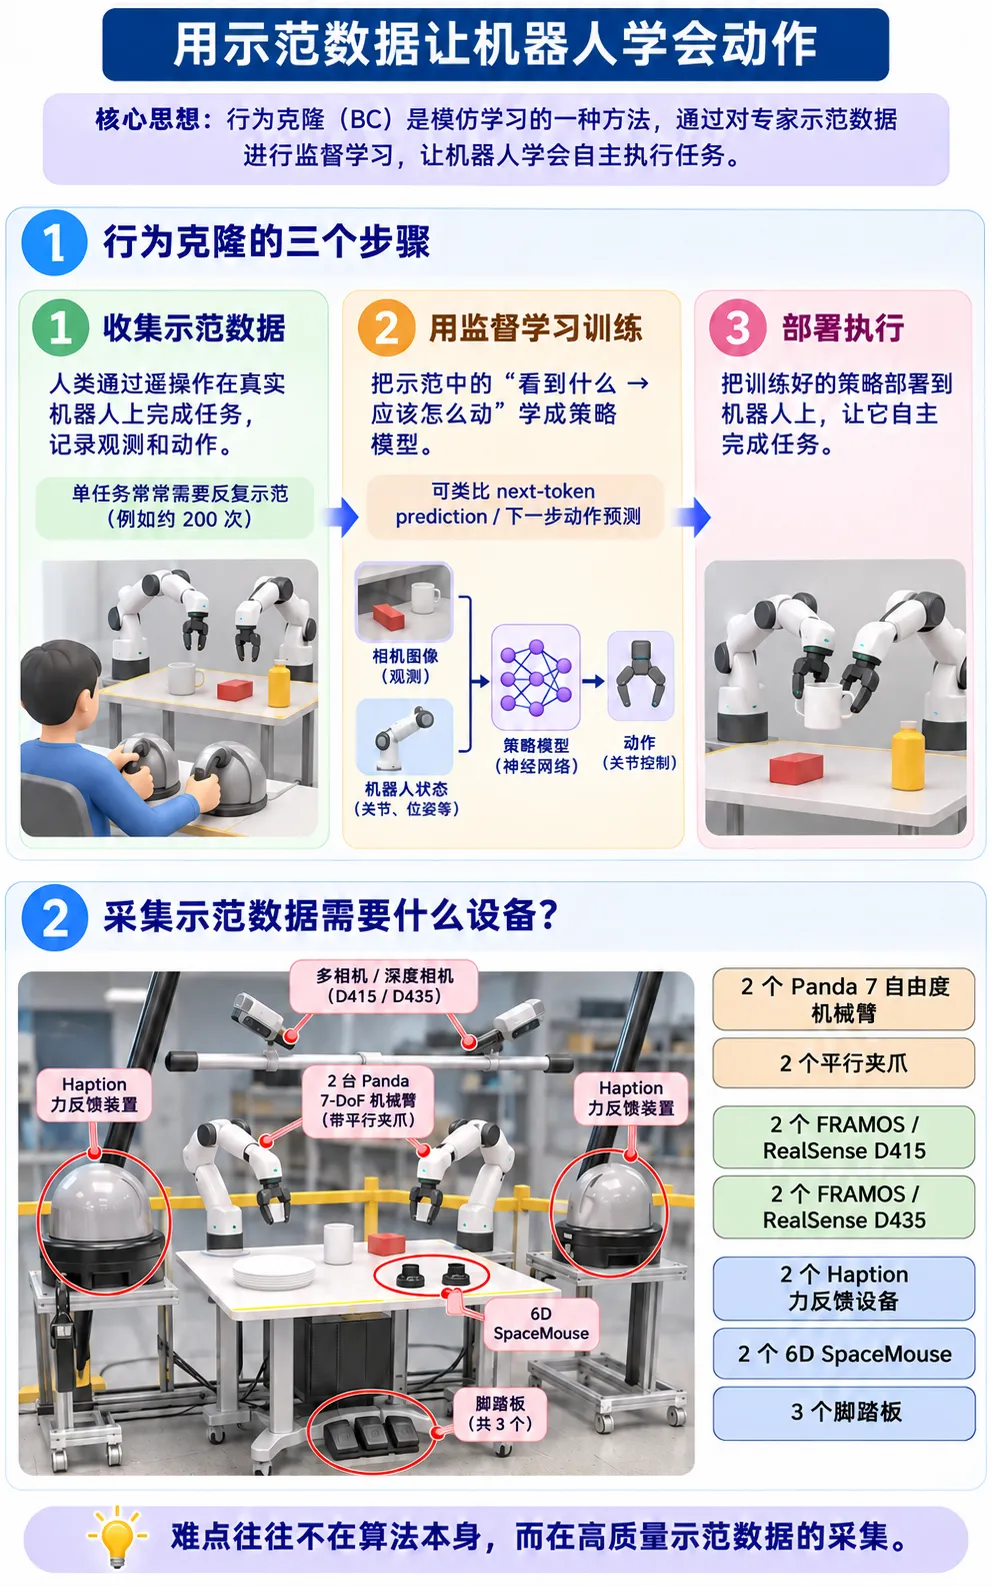 图 1 行为克隆的步骤及其典型采集设备。
采集的示范数据至少要同步四件事:
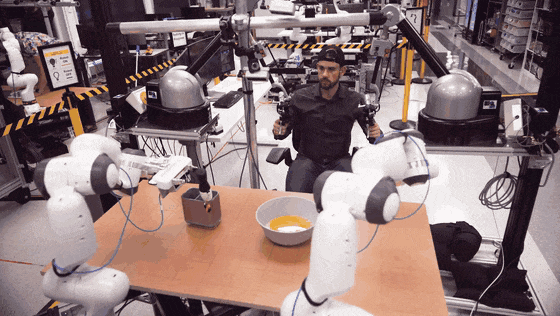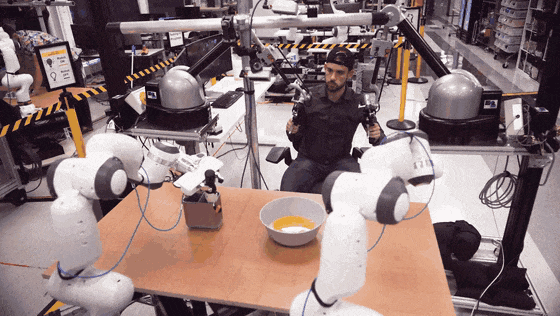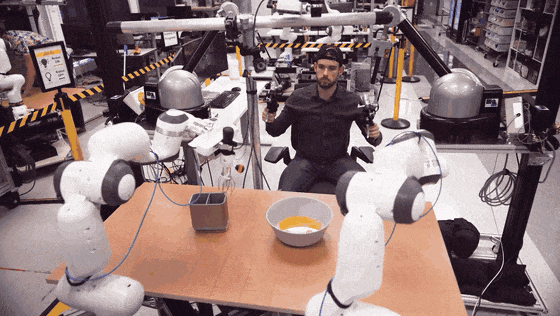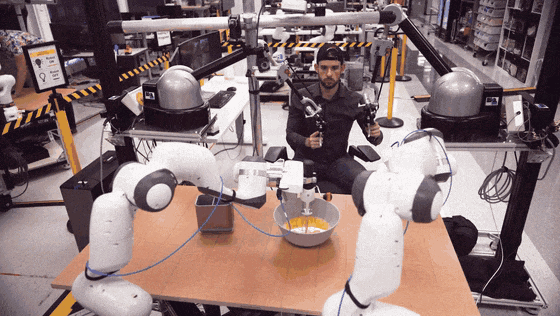 动图3 操作者通过触觉接口遥操作双臂完成桌面任务。
除了采用上面这套复杂的力反馈设备进行采集,UMI还提供了另一条简化思路:只用手持夹爪和腕部相机在真实环境中收集人类示范,再通过后处理把数据迁移到不同机器人。不过对于需要精确控制接触力的任务,例如精密插接等动作,还是需要额外的力觉或触觉传感器。〔4〕
在评估机器人的行为克隆(BC)模型能力时,不能只看任务成功率,还要关注测试条件的多样性。
UMI将多次实验的初始状态叠加显示,呈现了整理杯子、动态投掷、叠衣和洗碗这四个任务的初始状态变化,让大家能够直观地看到模型在各次测试中面对的初始条件,以及测试覆盖的变化范围。
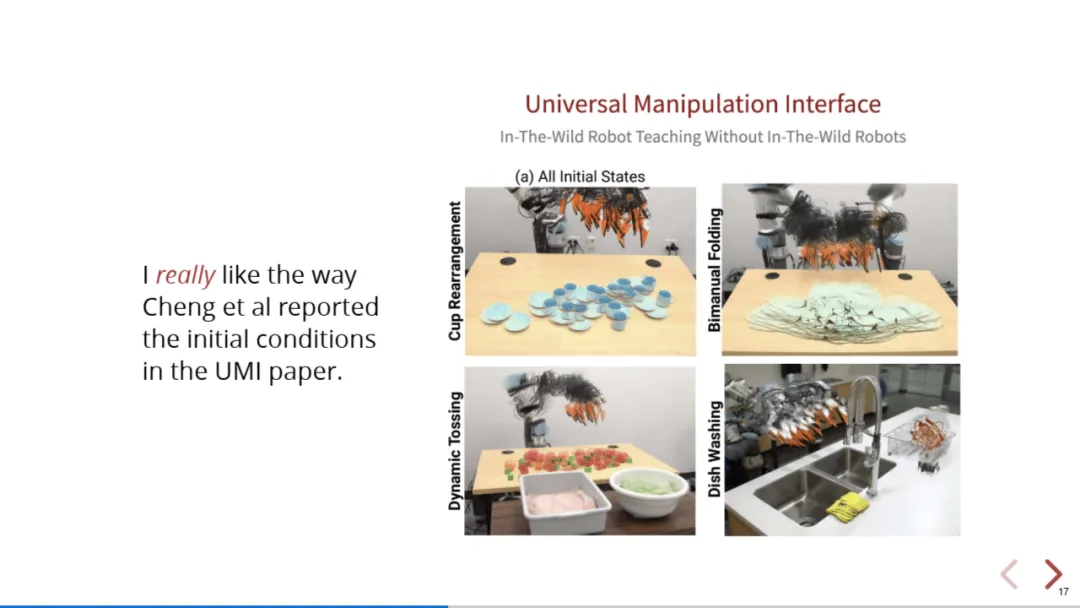 图 2 UMI 论文把杯子、衣物、食材和餐具等初始状态直接可视化。
传统机器人控制通常需要针对特定任务设计控制策略,或通过行为克隆(BC)学习专家的操作动作。不过随着大模型的快速发展,目前已经有另一种思路:利用已经预训练的通用视觉语言模型(VLM),通过Prompt和工具调用控制机器人,而无须专门将 VLM 训练成机器人动作模型。
整个系统由五个模块组成:
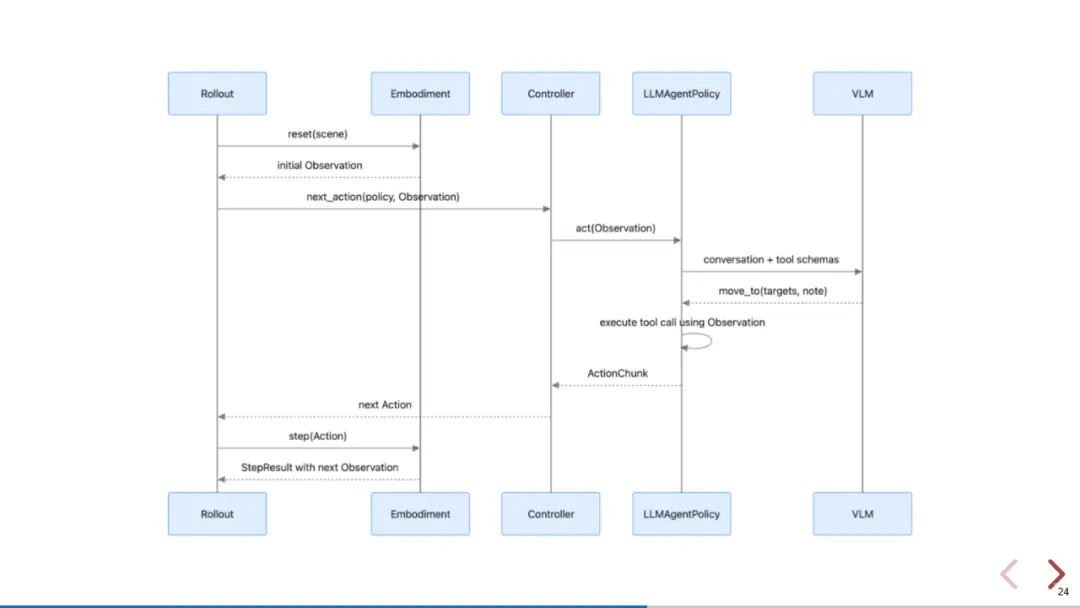 图 3 Rollout、机器人本体、控制器、LLM Agent Policy 与 VLM 形成工具调用闭环。
具体以“抓起红色积木”为例:
eef_pose);move_to(targets, note)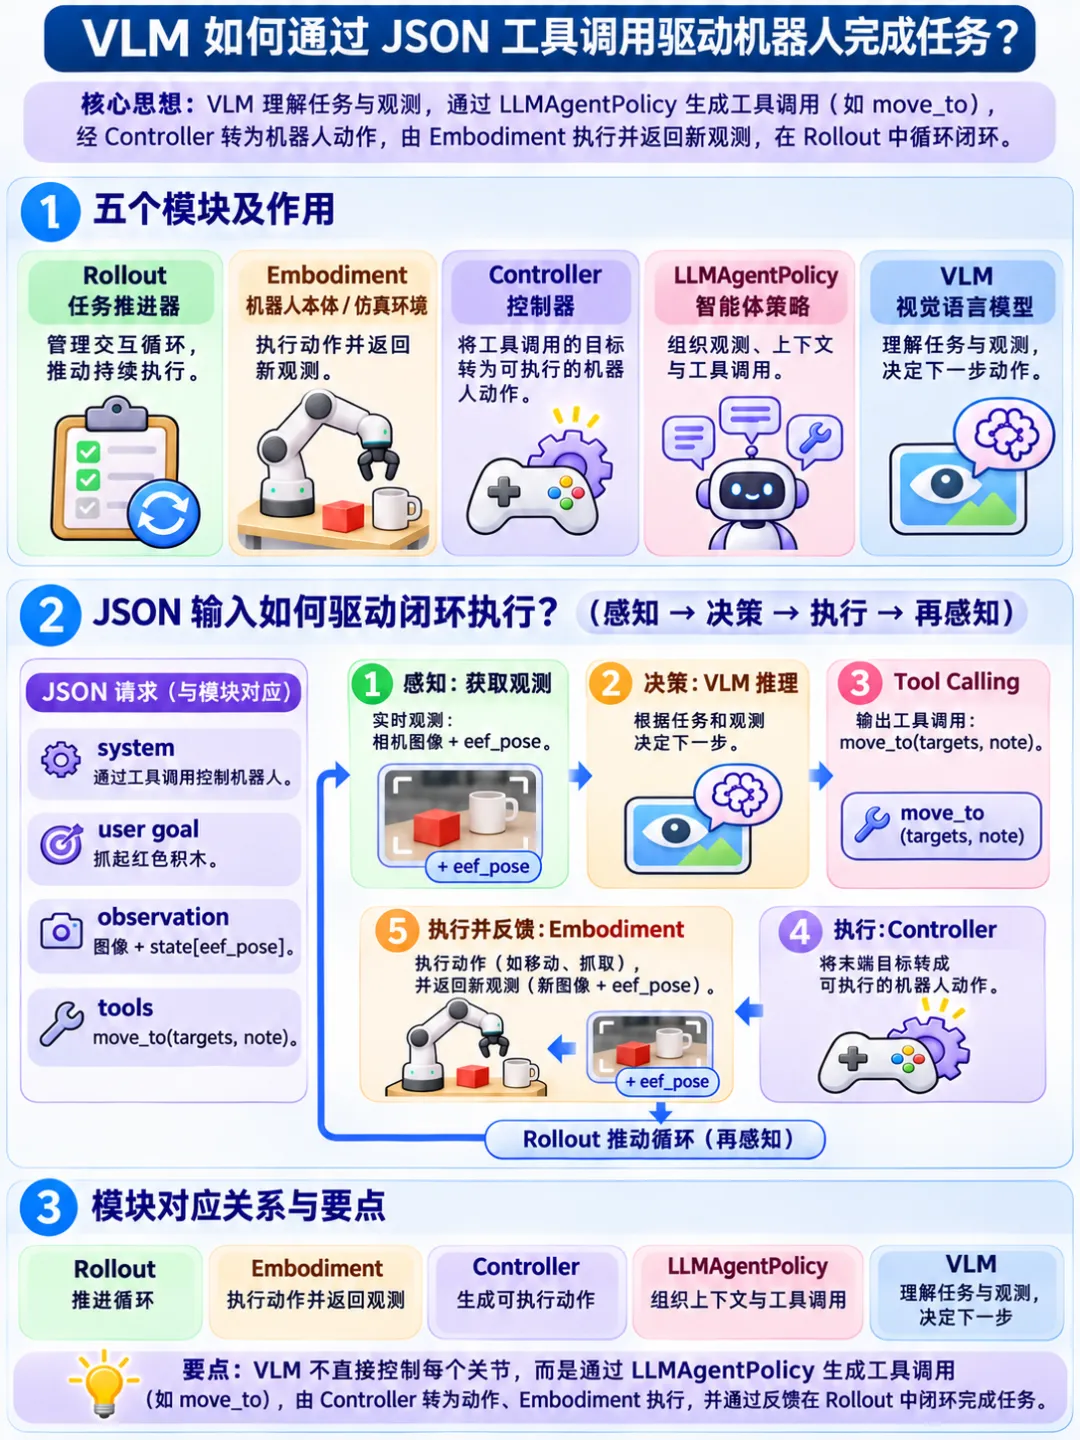 图 4 通用VLM利用标准工具接口控制机器人。
这套架构的价值在于将高层的智能决策与底层机器人控制解耦。 通用VLM可以借助标准工具接口参与机器人操作,而无须直接预测每个关节的控制量。
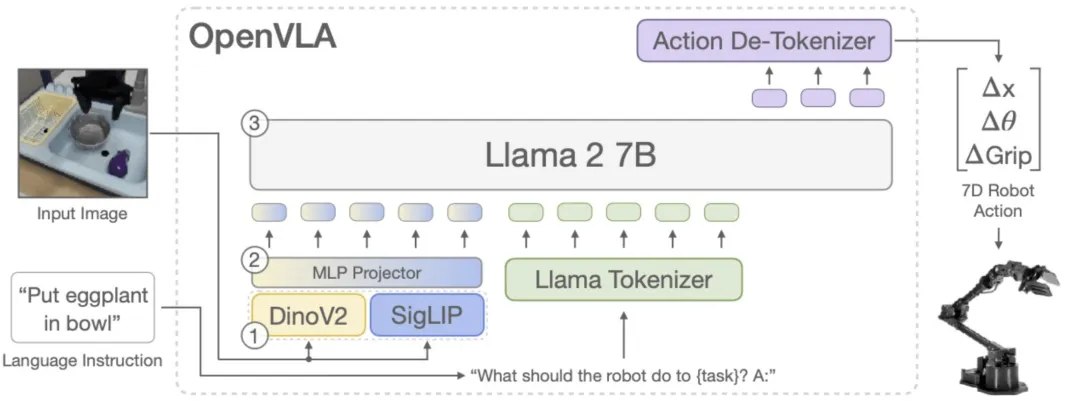 图 5 OpenVLA用DINOv2与SigLIP编码图像,经投影器送入Llama 2 7B,再把动作token解码为连续机器人动作。
OpenVLA 把“图像 + 指令 → 动作”改写为序列建模问题。动作先被离散为token,再解码为连续控制量。
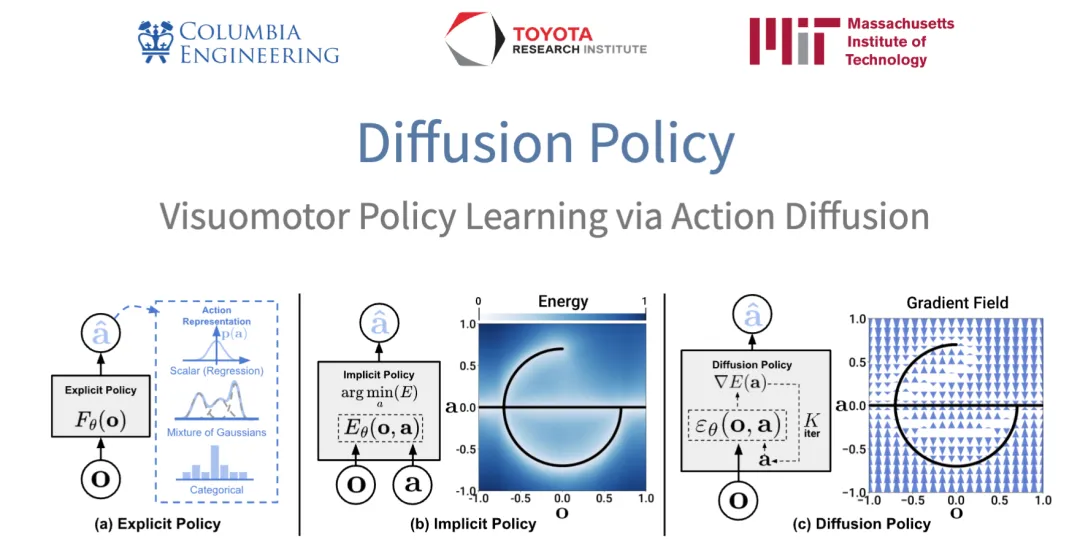 图 6 Diffusion Policy 把策略写成以观测为条件的动作扩散过程,通过迭代去噪生成动作序列。
设未来 步动作块为:
训练时对 加入不同强度噪声,网络学习根据观测 与噪声等级 预测噪声;推理时从随机噪声出发多次去噪,得到一条连贯动作轨迹。〔6〕
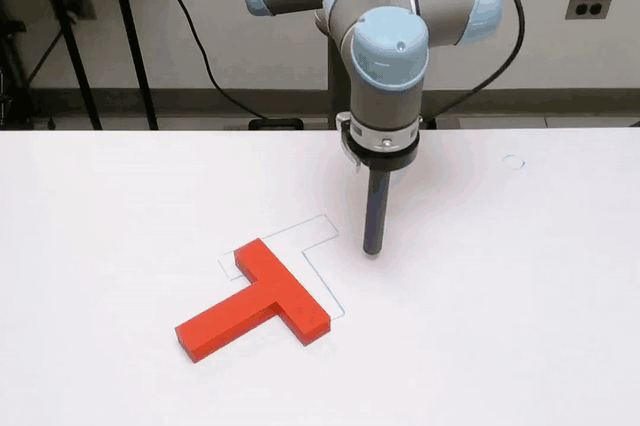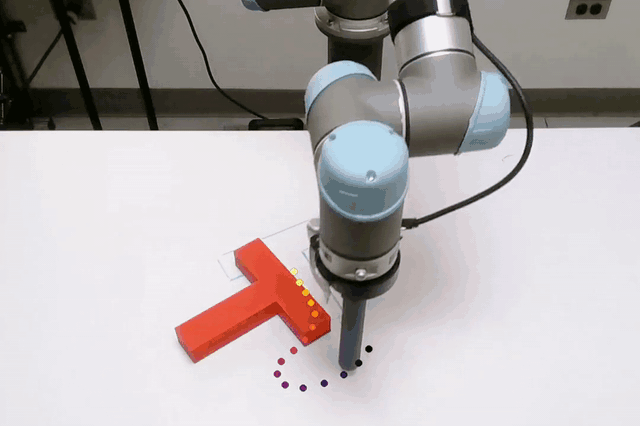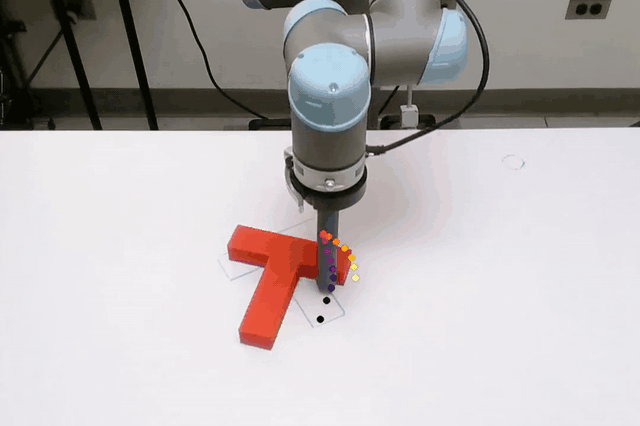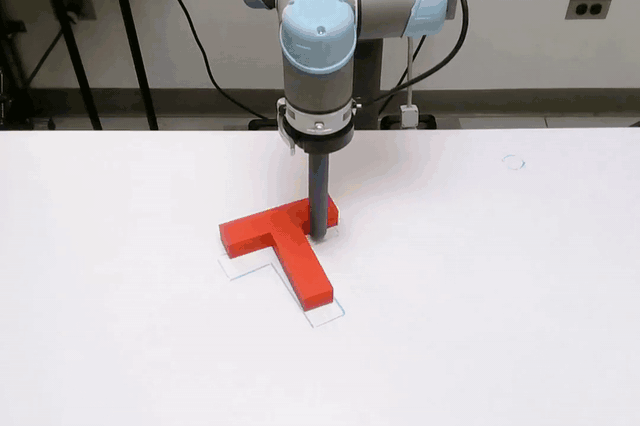 动图4 在Push-T 示例中,彩色候选从分散动作逐步收缩为可执行轨迹,机器人随后推动T形块。训练时,将加噪后的动作序列和当前观测输入模型,让它学习去噪并恢复合理动作。〔6〕
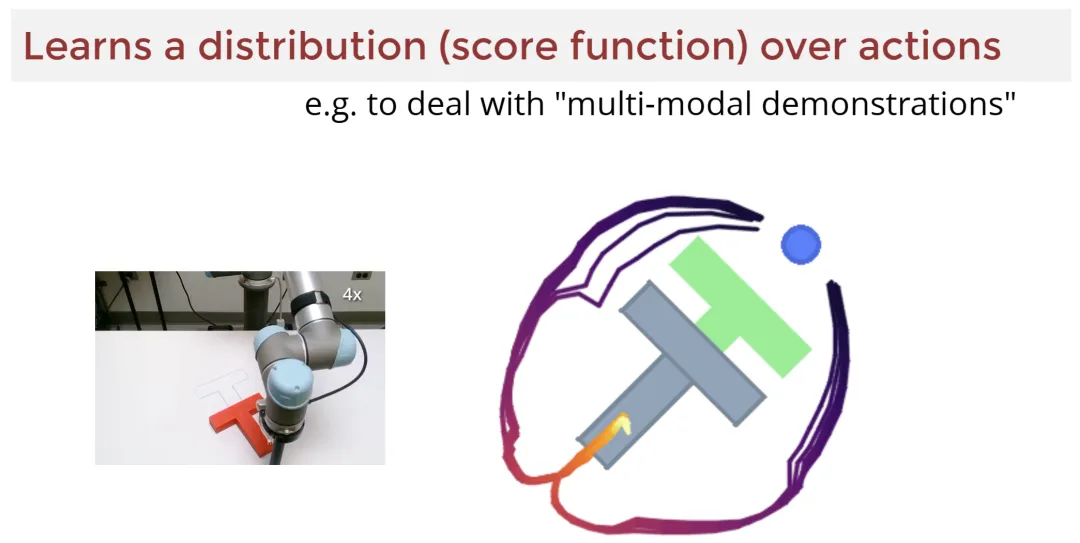 图 7 同一 T 形块可以从不同方向绕行并推动到目标区;学习一个分布可以保留这些模式,而如果采用均方误差回归,则可能将轨迹平均后变成一条碰撞轨迹。
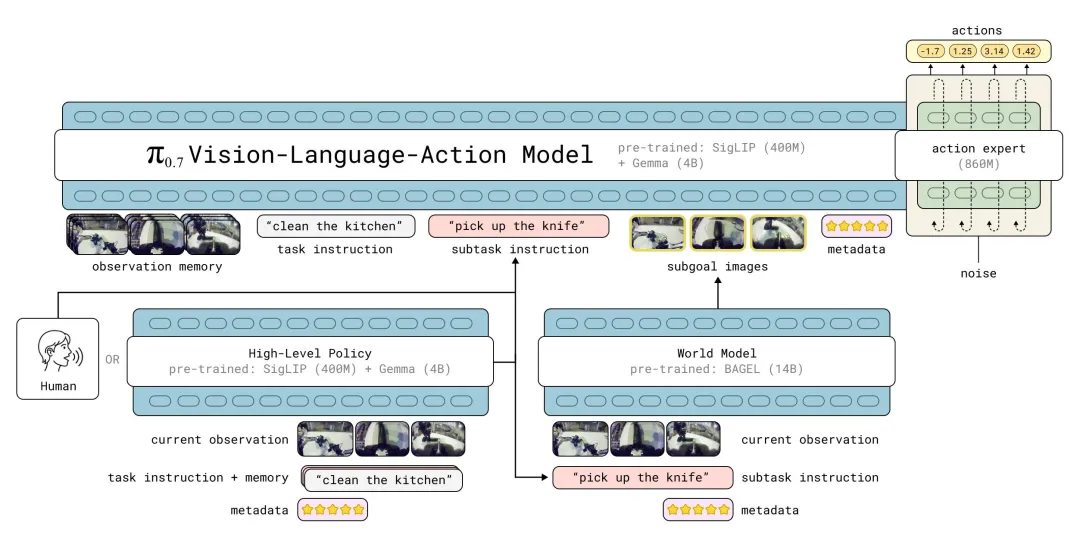
图 8 采用预训练的VLM主干+动作专家(Action Expert)协同工作,结合高层策略(High-Level Policy)、世界模型、视觉记忆及多模态提示,生成连续机器人动作。
里的两个Transformer分别承担不同的任务,简单对比如下:
π₀.₇ 采用两个网络协同工作:
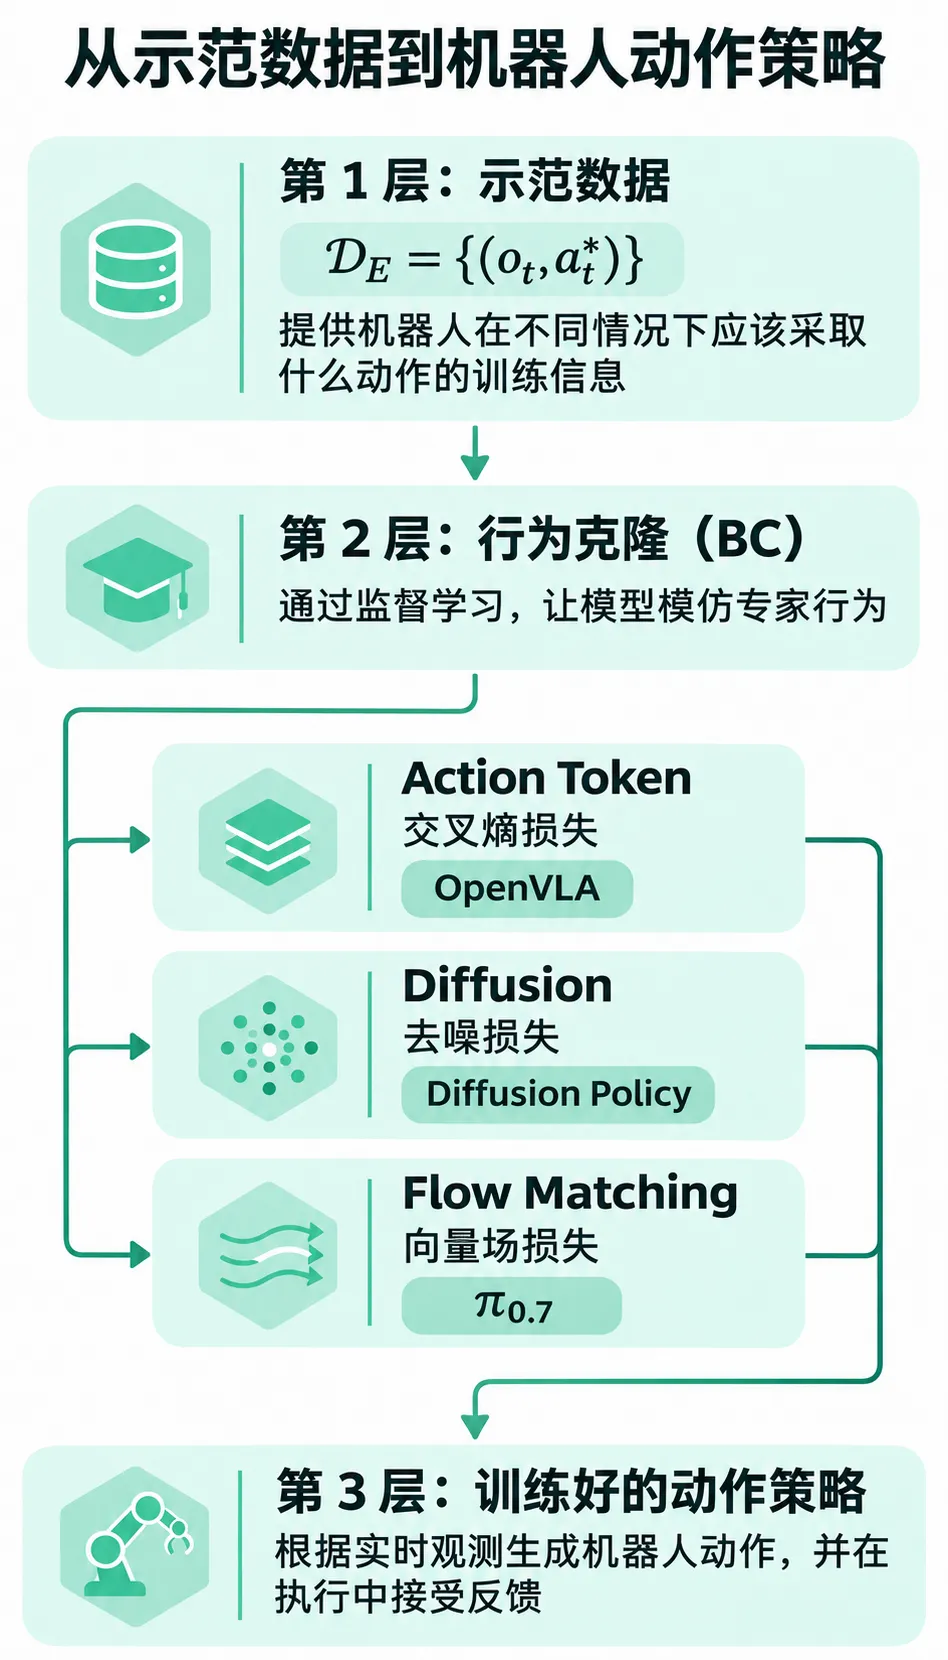
图 9 行为克隆(BC)决定“向专家学习什么”,而三种生成方法决定“如何学习和生成动作”。
MIT 6.4210/2 机器人操作 知识点笔记(1) MIT机器人操作 知识点笔记(2):机器人学习概览 MIT机器人操作 知识点笔记(3):坐标系与坐标变换 MIT机器人操作 知识点笔记(4):基础运动学 MIT机器人操作 知识点笔记(5):运动学优化 MIT机器人操作 知识点笔记(6):运动规划 MIT机器人操作 知识点笔记(7):机器人触觉仿真及抓取姿势生成

