他用 AI 拆完三科教材,然后干了一件更重要的事——把 AI 会错的地方全标了出来
- 2026-11-21 18:38:28
AI 会写代码、会写文章,这已经不新鲜了。但有一类活儿一直没人敢交给它——知识工程:把一整套国家课标逐条拆成知识点,理清几千个知识点之间谁是谁的先修,再为每个知识点配上机器可判的题目。这种活儿又脏又累,传统上是一个编辑部几轮校对的季度级工程,而且错一处就会误人子弟。
上周刷到一个仓库,把这个"不敢"变成了"干了":cn-math-taxonomy,一个人带着 AI,从建仓到今天只用了 8 天,已经有 3.9k star、964 个 fork,而且还在以每天几轮的速度迭代。
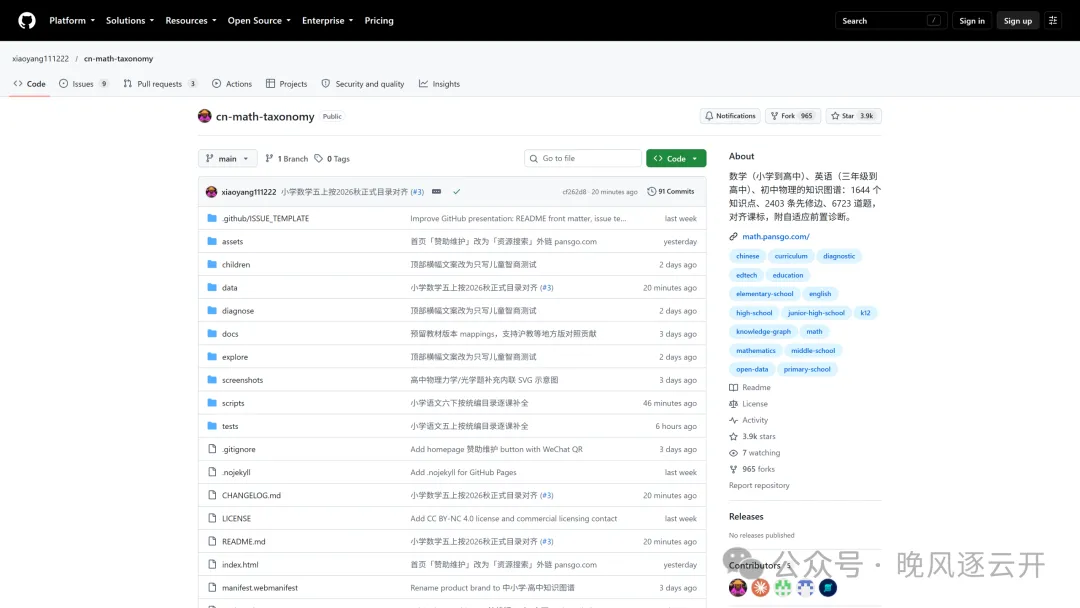
范围是中小学三大科:数学从小学一年级到高中选择性必修,英语从三年级到高中,物理从初中八年级到高中,教材全部对齐人教版现行版本(含 2024 年审定的初中新版),课标对齐《义务教育课程标准(2022 年版 2025 年修订)》和《普通高中课程标准(2017 年版 2025 年修订)》。
看它自己跑校验脚本输出的统计(README 里原文贴出,2026-10-23 版):
| 合计 | 1820 | 约 2900 | 7427 |
课标也不是口头说"对齐"了事——627 条课标条目原文逐条入了库,每个知识点都挂着对应的条目引用。数据格式是开放的 topics.json + dependencies.json 两个文件,参考了开源项目 os-taxonomy 的组织方式,意味着任何人都可以直接拿去用在自己的教育产品里。
二、做出来的东西长什么样
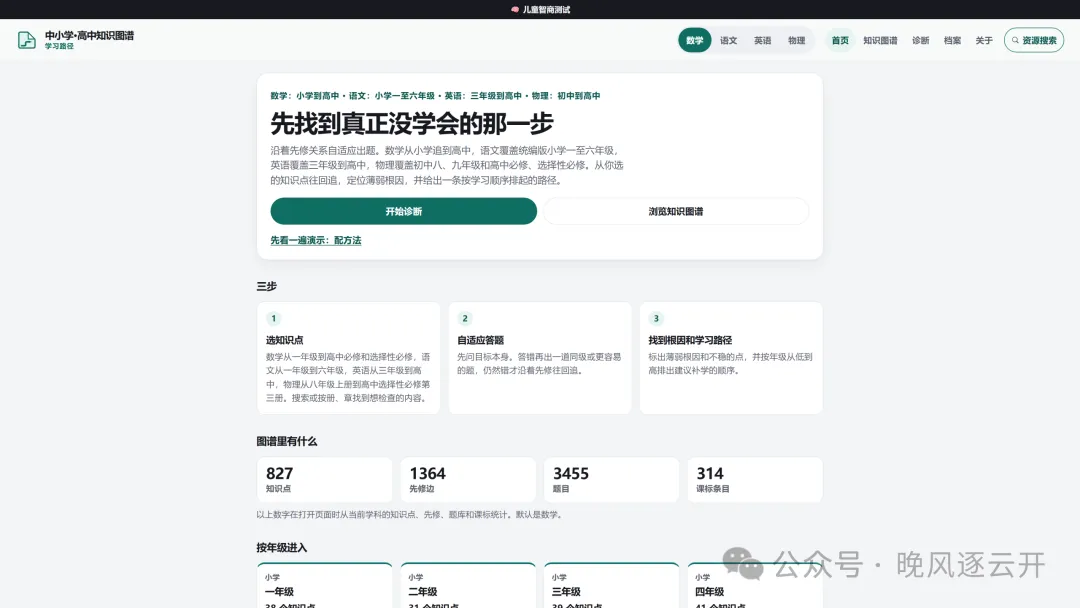
数据之上搭了一个纯静态网站(部署在 Cloudflare Pages,支持 PWA 离线),三个功能:
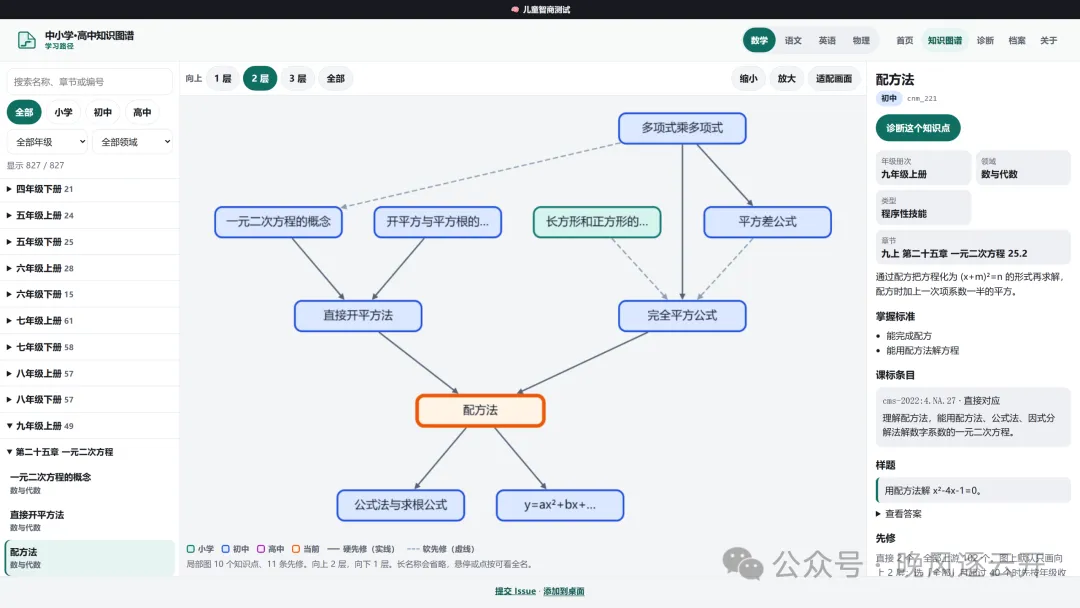
知识图谱可视化。 任选一个知识点,能看到它周围向上向下的先修网络——「配方法」往上两层的祖先是完全平方公式、整式乘法,再往上还有幂的运算,一张图看明白这节课的知识是从哪长出来的。
自适应前置诊断。 这是全站最有意思的功能:选一个目标知识点(或整章整册),系统按先修关系自适应出题。规则设计得很克制——第一题答对,视为掌握,全部祖先直接跳过;答错再出一道同级或更容易的,第二题也错才算薄弱,并沿着先修边往回追溯,先追硬依赖(hard)再追软依赖(soft)。所以一个高中生的「配方法」没过关,页面会一路回溯,把根子挖到小学的知识点上。每个知识点最多问 2 题,作者明说"诊断结果只是线索"。
网站内置了演示模式,程序模拟一位学生作答,全程不用动手:目标选「配方法」,模拟学生答错,系统第二题再错后判定薄弱,回溯出的根因直指「完全平方公式」——一张 Cytoscape 画的路径图把这条因果链画了出来。
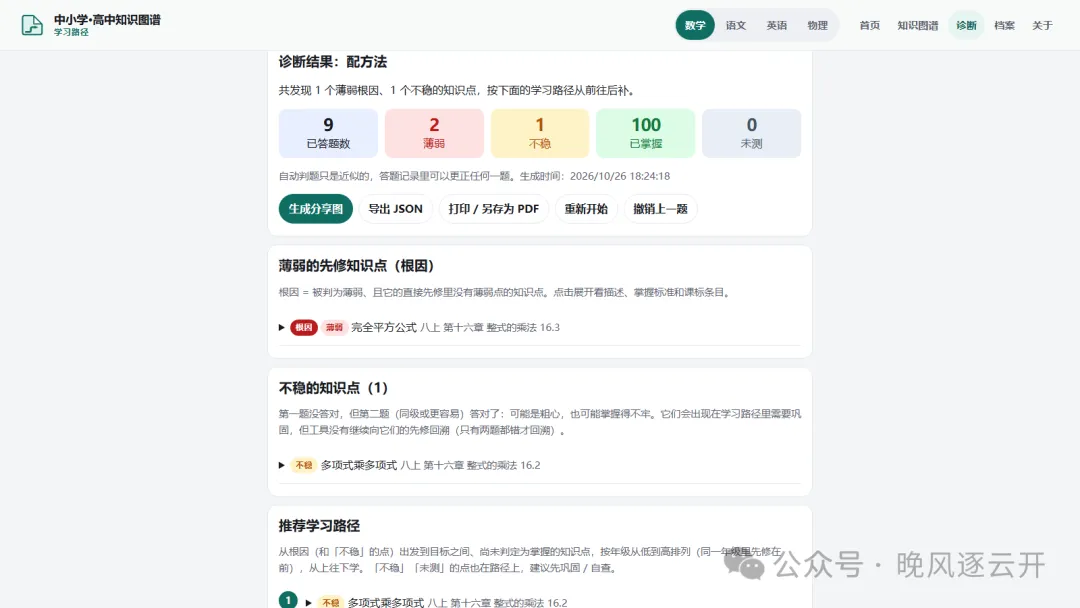
给娃辅导过功课的人应该秒懂这个场景的价值:孩子二次函数出错了,你盯着题目讲了一遍又一遍,其实窟窿在两年前的因式分解。"错在眼前,根在别处"是数学学习最典型的结构,而这张图把"别处"精确地指了出来。
三、主菜:他怎么治 AI 的幻觉
数据规模本身,AI 时代不稀奇——让它"生成"一千个知识点,它真能给你吐一千个。稀奇的是这个仓库对待生成结果的姿态:作者默认 AI 会错,然后建了一整套流水线把错误兜住。
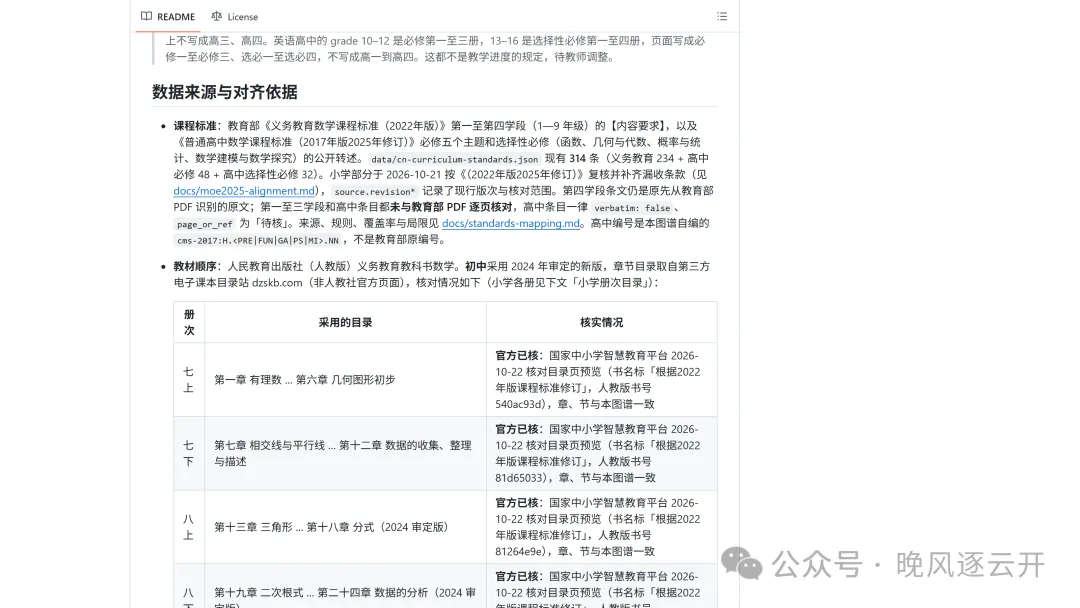
这套流水线大概四层:
第一层,机器判题核验。 数值题全部带 verify 字段——不是存一个答案字符串,而是存一条可执行的表达式,程序拿学生的算法重算一遍来判对错。题库跑 verify_questions.py,报告 mismatch 为 0。
第二层,独立复核与盲解。 小学数学的题有另一个独立程序只读题干和选项重算一遍,两套程序算出的答案不一致的条数为 0,日志全部留存;初中数学另有"盲解"复核——解题的程序和出题的程序不是同一段代码,避免"自己验自己"的循环。作者同时在 README 里老实承认:高中题和英语题还没做盲解,答案和校验来自同一条表达式。
第三层,来源分级标注。 每条数据的来源都被标了等级:"官方已核"(初中五册教材目录逐册在国家中小学智慧教育平台核对过章节)、"待核"(高中课标条目一律标记 verbatim: false,注明未与教育部 PDF 逐页核对)、"非官方推定"(2027 年才启用的九下教材,官方还没发布目录,作者综合了四个第三方来源做交叉考证,连"为什么不用某个来源"都写明了理由)。
第四层,全量校验脚本。validate.py 对 1820 个知识点、2900 条边、7400 道题做结构性校验,README 里的统计表就是它的实际输出,改完一轮跑一遍,数字变了立刻能看出来。
这四层里最打动我的其实是第三层。多数 AI 生成项目的问题是"把生成当成品",而这里每一条数据都带着自己的可信度标签——你引用任何一条,都知道它后面站的是官方原文、程序核验,还是一份待人工复核的草稿。README 开篇第一句话就是"这是 AI 生成的初稿,未经任何教师审核",先把底牌亮给你看。
四、边界说在前面
三条,原样转达:
• 许可证是 CC BY-NC 4.0:可自由使用、修改、分发,但禁止商用。想拿去做商业教育产品的,先看清这条。 • 未经教师审核:知识点的拆分粒度、先修边该不该存在、题目答案,作者明确说需要一线教师审核后才能用于教学、诊断或学习路径推荐。英语部分的高中课标条目目前全部标"待核",不要当成官方原文。 • 诊断只是线索:每个知识点最多两道题的采样,结果是一个排查起点,不是一份诊断书。
写在最后
这个仓库最值得看的,其实不是那张图谱本身,而是它示范了一种工作方式:把 AI 当成高速的初稿生成器,然后用自己的流水线去丈量它每一寸输出。哪些可以信、哪些必须核、哪些干脆承认还没做——全部写在明面上。
AI 生成的内容满地都是的今天,"逐条标注可信度"可能比"生成"本身值钱得多。这个 8 天的项目,价值不在那 1820 个知识点,而在那份诚实。
觉得有收获,「赞」「推荐」「转发」就是最大的鼓励 欢迎在评论区留下你的想法!
KEEP EXPLORING…
🌟 点亮星标 🌟
愿你拆开的每一层知识,都连着根

