DeepTutor:一个围绕你的教材、笔记和错题工作的 AI 原生导师
- 2026-11-22 00:16:02
你可能也这样用过 AI 学习:上传一份 PDF,让它概括重点;碰到不懂的地方,继续追问;临近考试,再让它出几道题。
问题往往出在第二天。讲过哪些知识、哪道题还没弄懂、错题存在哪里,需要自己重新整理。对话越来越长,学习材料却仍然散在不同地方。
HKUDS 开源的 DeepTutor,想把这些事情放进同一个学习工作区:围绕你选定的教材、论文和笔记,阅读、提问、解题、练习,再把学习记录留下来。
功能列了不少,真正用起来时,它们怎么配合?装好之后,第一步该做什么?
一、DeepTutor 到底是什么?
可以把它理解为一个需要自己配置模型的 AI 学习工作台。模型负责理解和生成,DeepTutor 负责组织资料、调用工具、安排不同学习流程,以及管理记录。
官方把产品定位为“终身个性化辅导”。从功能看,它覆盖了几类常见需求:
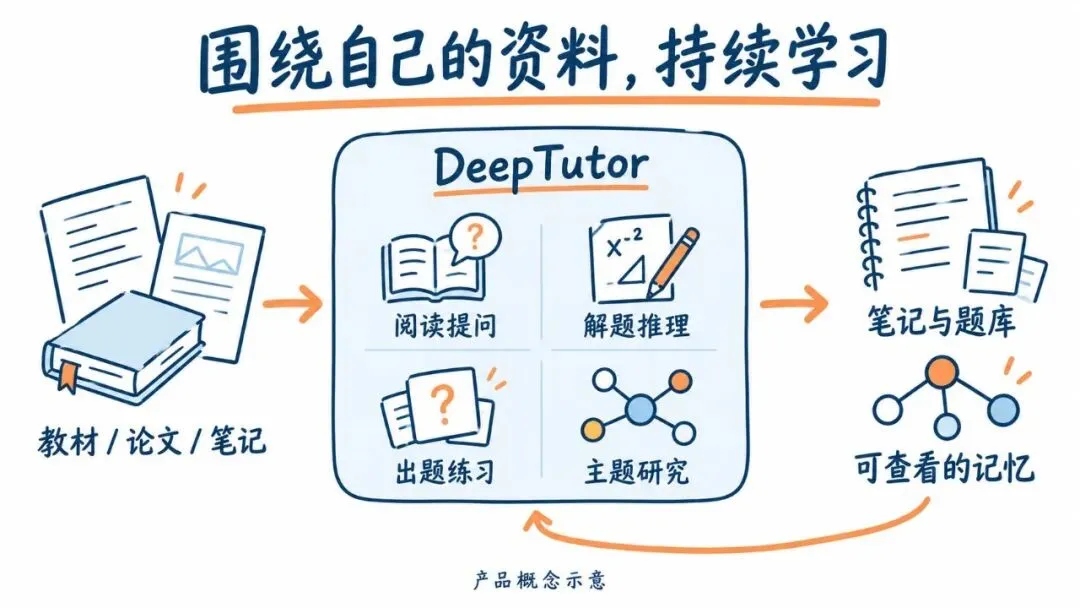
这些入口可以在受支持的流程中复用知识库、笔记、题库等资源。具体能用哪些资源,还受账号权限和学习策略限制。
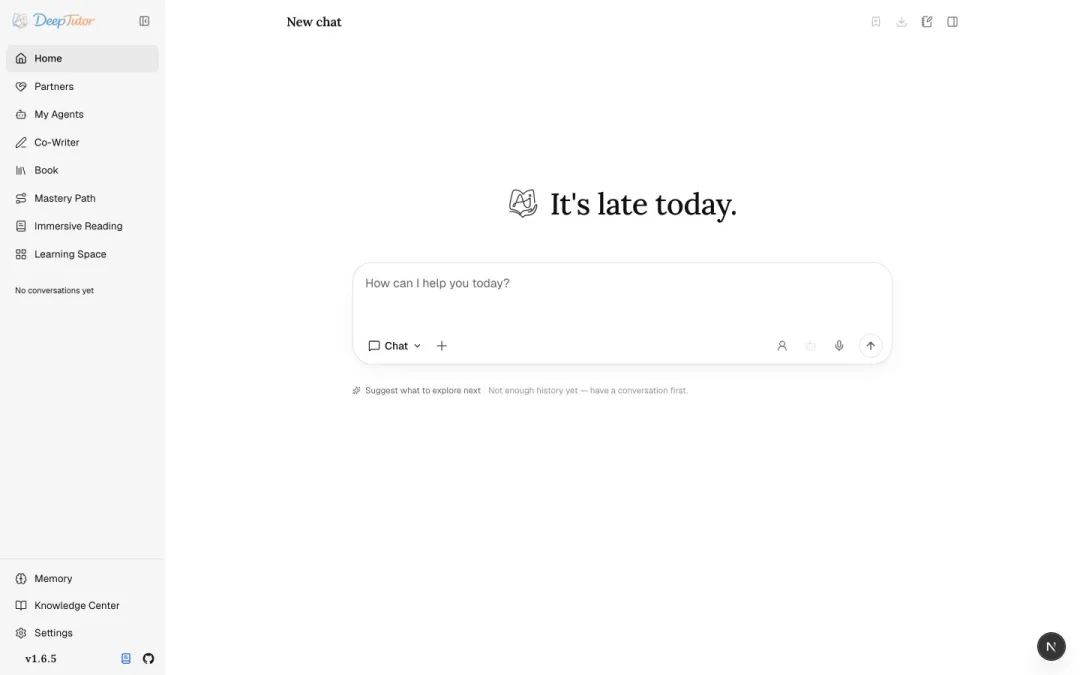
下面的介绍依据官方 README 和发布说明,尚未在本机部署实测。文中的学习指令是使用示例,不是实际运行结果。
二、它的优势,落在这三个具体地方
1. 同一套资料,可以继续拿来读、问、练
假设你正在学线性代数,手上有一本教材、老师的讲义和自己的课堂笔记。
DeepTutor 的 Knowledge Center 可以把文档组织成知识库,为问答、写作和 Book 等流程提供检索依据。这里的 RAG,可以简单理解为:回答之前,先从选定的资料里找相关内容。
这有助于围绕课程自己的定义、符号和章节展开讨论。回答是否贴合原文,仍要看资料解析、检索和模型表现,不能因为接入了知识库就默认正确。
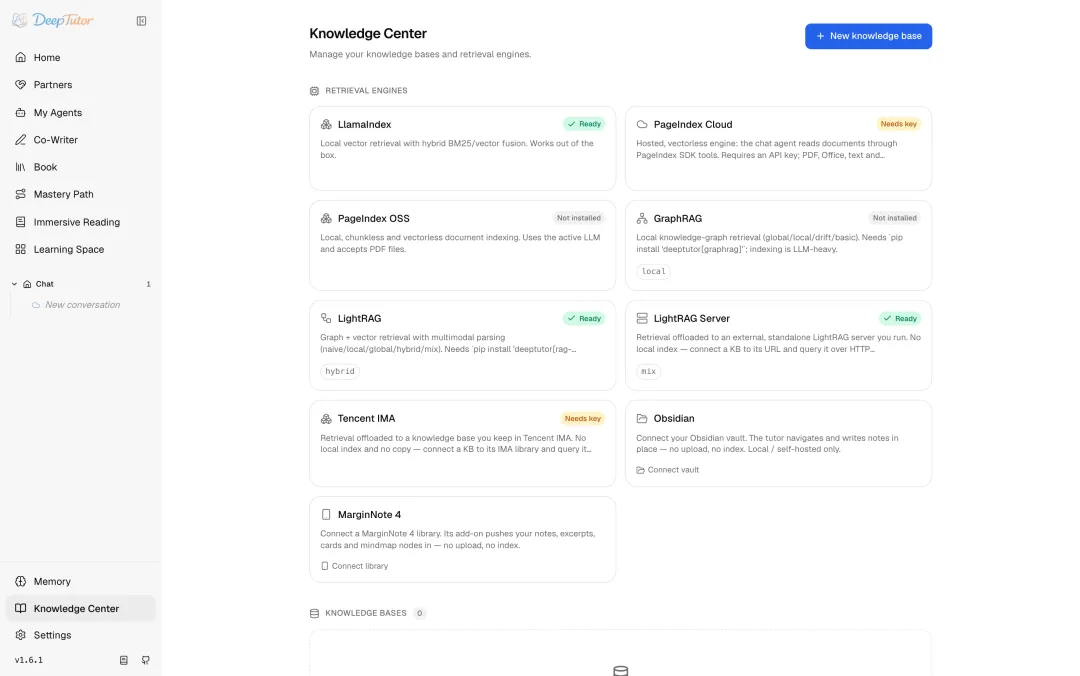
项目提供 LlamaIndex、PageIndex、GraphRAG、LightRAG 等检索方案,也支持连接部分外部资料库。初次使用建议从默认的 LlamaIndex 开始,先确认一份文档能被正确读取和检索,再考虑更换引擎。
另一个值得关注的功能是 Book。它会先根据选定资料提出章节大纲,供你审阅,再生成包含正文、测验、闪卡、图示等内容块的书籍。章节可以继续编辑,也能导出 Markdown。
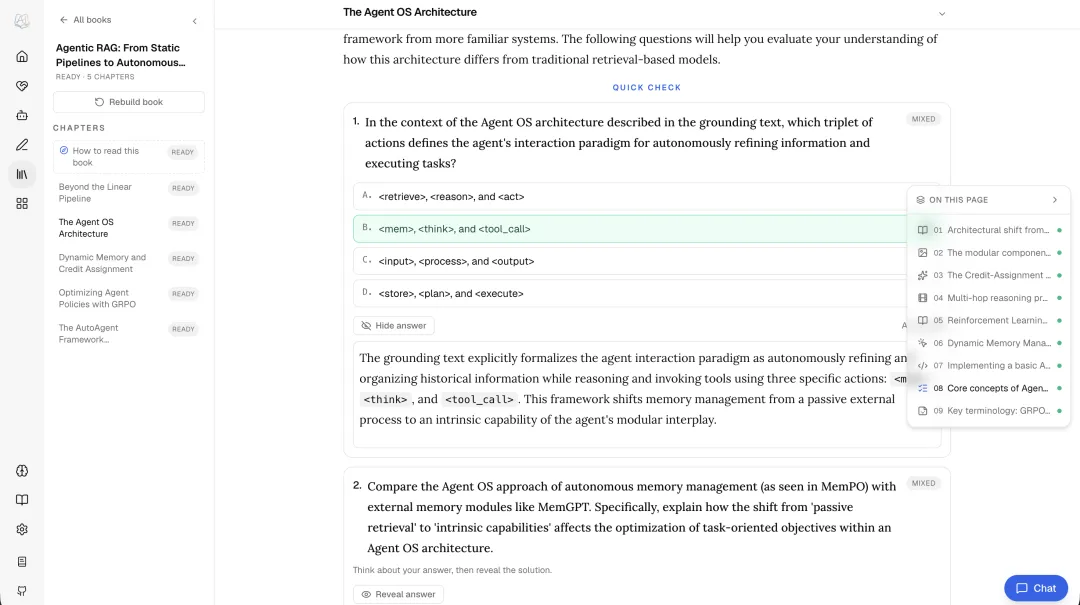
如果你手上是一组零散论文或课程笔记,这种先审大纲、再组织内容的方式,比一次要求 AI 输出整份长文更容易检查结构是否合理。
2. 把“看懂了”推进到“自己能讲出来”
让 AI 解释一个知识点,和自己能够解题,是两回事。
DeepTutor 把出题、学习路径、题库和复习做成了不同入口。官方文档说明,Practice 支持从题库选题练习、记录错误和安排重复复习;Mastery Path 则围绕学习路径推进。
v1.6.15 的发布说明还提到,学习路径可以预览调整,导师可以一次给出一组问题并分别评估答案。对概念的掌握,仍要求学习者自己解释。
练习时可以先自己回答,再让 AI 检查遗漏和错误,最后回到材料里补上那一段。别一开始就把答案全展开。
3. 学习记录可以查看,个性化有迹可循
官方的 Memory 设计分为三层:原始活动记录、各功能整理出的事实,以及跨功能的综合信息。Memory Graph 可以展示其中的关联,相关记忆也可以查看和整理。
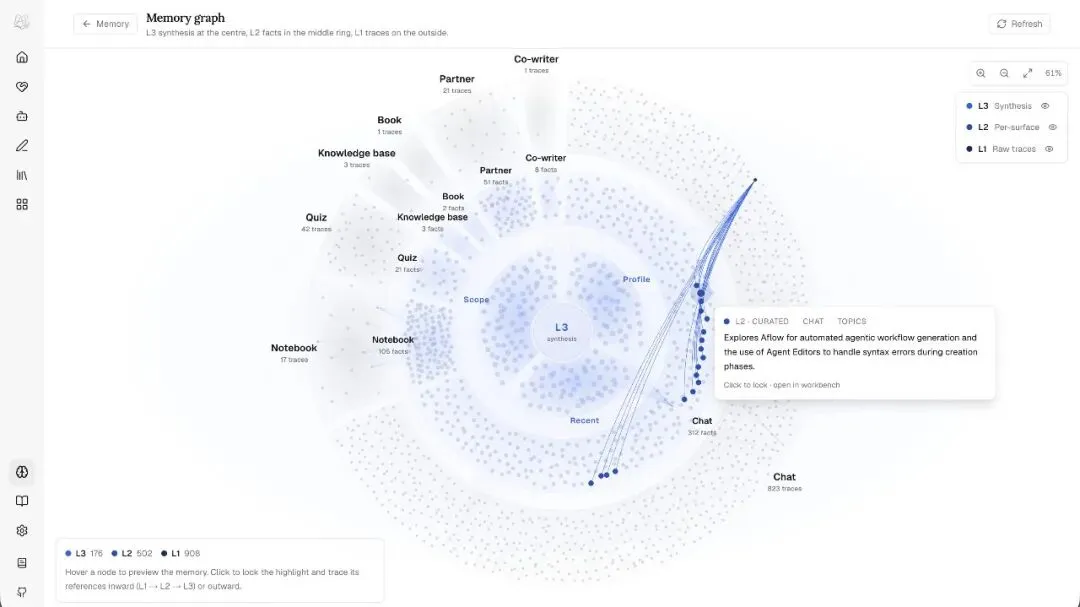
这比一句“AI 会记住你”更具体:你可以检查它记录了什么,是否与自己的情况相符。
但“有记忆”不等于“准确理解了你的学习水平”。薄弱点判断、评分和学习建议,仍然需要结合自己的作答与原始资料核对。
三、怎么开始用?先跑通一个小任务
第一步:选一种安装方式
电脑已经装好 Docker,可以用官方的一条命令试运行:
docker run --rm --name deeptutor \ -p 127.0.0.1:3782:3782 \ -v deeptutor-data:/app/data \ ghcr.io/hkuds/deeptutor:latest启动后,在浏览器打开 http://127.0.0.1:3782。
这条命令只把服务绑定到本机地址。设置和本地数据保存在 deeptutor-data 数据卷里;按 Ctrl+C 停止本次运行后,数据卷仍会保留。
习惯 Python 环境,也可以通过 PyPI 安装:
官方要求 Python 3.11–3.14,以及 PATH 中可用的 Node.js 20+。建议在独立的 Python 虚拟环境里执行:
mkdir -p my-deeptutorcd my-deeptutorpip install -U deeptutordeeptutor initdeeptutor startinit 会引导你配置端口、模型,以及可选的 Embedding 和搜索服务。启动后,以终端打印出的访问地址为准。
第二步:把模型接上,再考虑其他功能
进入 Settings → Providers,填写所用服务商的地址和凭证;再到 Language models 添加并选择模型。
这里要分清几个角色:
• 语言模型负责讲解、推理和生成,是先要配置好的部分。 • Embedding 模型用于需要向量索引的知识库检索,使用相应 RAG 功能时再配置。 • 搜索服务用于联网检索;图片、语音、视频等能力也有各自的配置条件。
建议先发一条普通问题,确认模型能正常回答,再上传一份较短、文字清晰的材料。先不要把所有功能一次配齐。
如果你在 Docker 中连接宿主机上的本地模型,容器里的 localhost 指向容器自身。官方给出的方式是使用 host.docker.internal;Linux 环境还可能需要增加主机网关映射,具体参考仓库的本地模型说明。
第三步:拿一章教材,完成一次“读—问—练—复习”
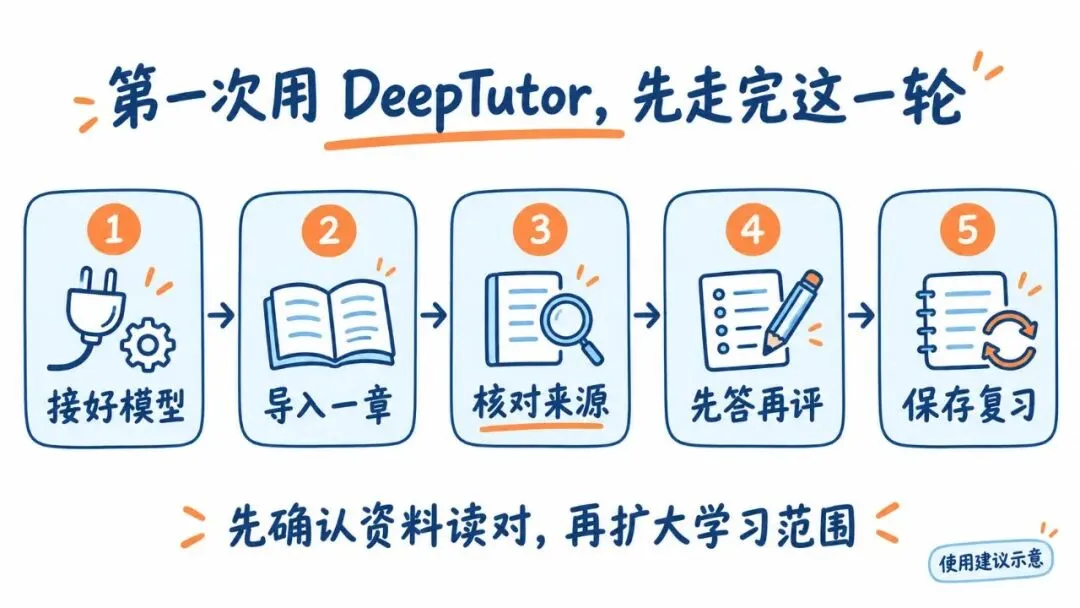
下面以线性代数中的“特征值与特征向量”为例。你可以换成自己的课程章节。
先确认材料读对了。 在 Knowledge Center 创建知识库,上传材料,等待解析和索引完成。回到 Chat,选中该知识库后提问:
请根据我选中的材料,列出“特征值与特征向量”这一章的核心概念,并给出能核对的来源位置。材料没有讲到的内容,请单独说明。
拿两三处答案与原文对照。如果页码、公式或引用明显不对,先处理解析和检索问题,不要急着生成整套课程。
再把卡住的地方问清楚。 进入 Reading 阅读相关材料,或者在 Chat 中继续指定问题:
我不理解“矩阵作用后方向不变”的含义。请结合这章的定义解释,先问我一个判断题,等我回答后再继续。
然后自己作答。 用 Quiz 或 Mastery Path 围绕这个主题练习,可以把要求写具体:
根据选定材料,出 3 道由易到难的题,覆盖概念判断、简单计算和条件辨析。先让我提交答案,再逐题讲解,并指出我漏掉的条件。
最后留下可以复用的记录。 把值得复习的题目和解释整理进题库、笔记,再用 Practice 复习。检查 Memory 中的相关记录,纠正与实际情况不符的内容。
这一轮最值得观察的是:答案能否找到依据,错误有没有被指出,隔天能否接着复习。能把这几件事做顺,再考虑生成 Book 或搭建更长的学习路径。
四、哪些人值得试?哪些成本要先想清楚?
如果你有明确的学习主题、自己的资料,并愿意配置模型,可以试试 DeepTutor。备考、系统自学、持续阅读某个研究方向,都可能用到它的资料库和学习记录。
如果只是偶尔问一道题,现有聊天工具可能已经够用。DeepTutor 功能丰富,也意味着要管理模型、资料解析、索引和运行环境。
我是Qilo,关注我获得更多最新消息
引用链接
[1] DeepTutor 官方仓库与使用说明: https://github.com/HKUDS/DeepTutor[2] v1.6.15 发布说明: https://github.com/HKUDS/DeepTutor/releases/tag/v1.6.15[3] 官方安装配置指南: https://github.com/HKUDS/DeepTutor/blob/main/docs-for-user/AGENT_SETUP.md

